أغلب اللي يسوون activation patching على لابتوب يشتغلون على ملف GGUF مضغوط، عشان هو اللي يقدرون يشغلونه. طيب السؤال: هل هذي نفس التجربة لو سويناها على النموذج الأصلي اللي انضغط منه؟
سويت patch لكل candidate على أربع نسخ من نموذجين، وقارنت كل نسخة مضغوطة بأصلها الـF16. الأماكن اللي تحمل الجواب طلعت متفقة مرة في كل النسخ. بس ترتيب الأماكن اللي تأثيرها شبه صفر ما اتفق، وهذا الاختلاف هو اللي كسر القاعدة اللي كتبتها قبل ما أبدأ.
نموذجين instruction صغار، قالب واحد لاسترجاع معلومة، وست أزواج prompts بس. يعني ما نقدر نقول منها شيء عن نماذج أكبر، ولا circuits ثانية، ولا quantizers غير اللي في llama.cpp. والـF16 هنا مرجع، مو الحقيقة المطلقة: هو نفسه تقريب لأوزان BF16 الأصلية.
الـprompt هو The capital of {country} is the city of. الـprompt النظيف فيه دولة، والـcorrupted فيه دولة ثانية، وعندنا ست أزواج مثل فرنسا وإيطاليا. المقياس هو logit عاصمة النظيف ناقص logit عاصمة الـcorrupted عند آخر موقع.
لكل نموذج أربع مستويات: ملف F16 الأصلي، وبعدها Q8_0 وQ6_K وQ4_K_M، كلها مصنوعة من نفس الملف بنفس نسخة llama.cpp المثبتة. يعني الفرق الوحيد بين المستويات هو الضغط، ولا شيء غيره.
الـcandidate هو مكان واحد (الـresidual stream الداخل للـblock، أو مخرج الـattention، أو مخرج الـMLP) في layer واحدة وعند token واحد. المواقع تبدأ من token الدولة إلى الآخر، لأن اللي قبلها نفسه بالضبط في الـpromptين. كذا يطلع عندنا 240 candidate لكل تشغيل Llama و420 لكل تشغيل Qwen.
كل candidate انعمل له patch حقيقي: الـprompt الـcorrupted يشتغل وفيه الـactivation النظيفة مكتوبة في هذاك المكان بس. التأثير المقاس هو كم تغير المقياس، والـrecovered fraction هو التأثير مقسوم على الفجوة بين النظيف والـcorrupted. التقدير الأرخص في Ember انحفظ، بس مو هو اللي نقارنه هنا.
الـ72 تشغيل كلها جاوبت صح: كل prompt نظيف يفضل العاصمة الصحيحة، وكل corrupted يفضل الثانية. وكل bundle عدى الـverify، والـhashes حقته موجودة في ملف الـprovenance المنشور.
قبل أي تشغيل سجلت قاعدة قرار: المستوى ينحسب إنه يعطي نفس استنتاجات F16 إذا في كل زوج كان Spearman للتأثيرات المقاسة على كل الـcandidates 0.9 أو أكثر، وأقوى مكان هو نفسه، والأماكن اللي ترجع 20% أو أكثر من الفجوة تتداخل بـJaccard 0.8 أو أكثر.
ولا مستوى في أي نموذج نجح. Q8_0 في Llama، وهو الأقرب للـF16، وصل median Spearman 0.90 وطابق أقوى مكان في زوج واحد بس من ستة. وQ4_K_M في Qwen وصل median 0.62.
الشرط الثالث مشى تقريباً في كل مكان: الأماكن المهمة تداخلت بـJaccard 0.85 أو أكثر في كل مستوى. اللي فشلوا هم أول شرطين، فرحت أشوف إيش يقيسون أصلاً.
أغلب الـcandidates تأثيرها شبه معدوم. في F16، 75% من candidates في Llama و87% في Qwen ترجع أقل من 2% من الفجوة. ضوضاء الضغط تخلط ترتيب هذي التأثيرات الصغيرة بحرية، والـrank correlation على كل الـcandidates يصير في الغالب يقيس هذا الخلط بس.
وأعلى القائمة شبه تعادل. لو سويت patch للـresidual stream عند token الدولة في أي layer بدري، ترجع الفجوة كلها تقريباً، فأحسن مكانين في F16 الفرق بينهم 0.4 نقطة مئوية بالأكثر. مين يجي الأول قريب من رمي عملة. وفي كل مستوى، أقوى مكان في النسخة المضغوطة يرجع في حدود 1.5 نقطة من أحسن مكان في F16.
يعني القاعدة كانت تختبر شيئين ما يهمون في التفسير: ترتيب الأماكن الهامشية، والترتيب داخل التعادل.
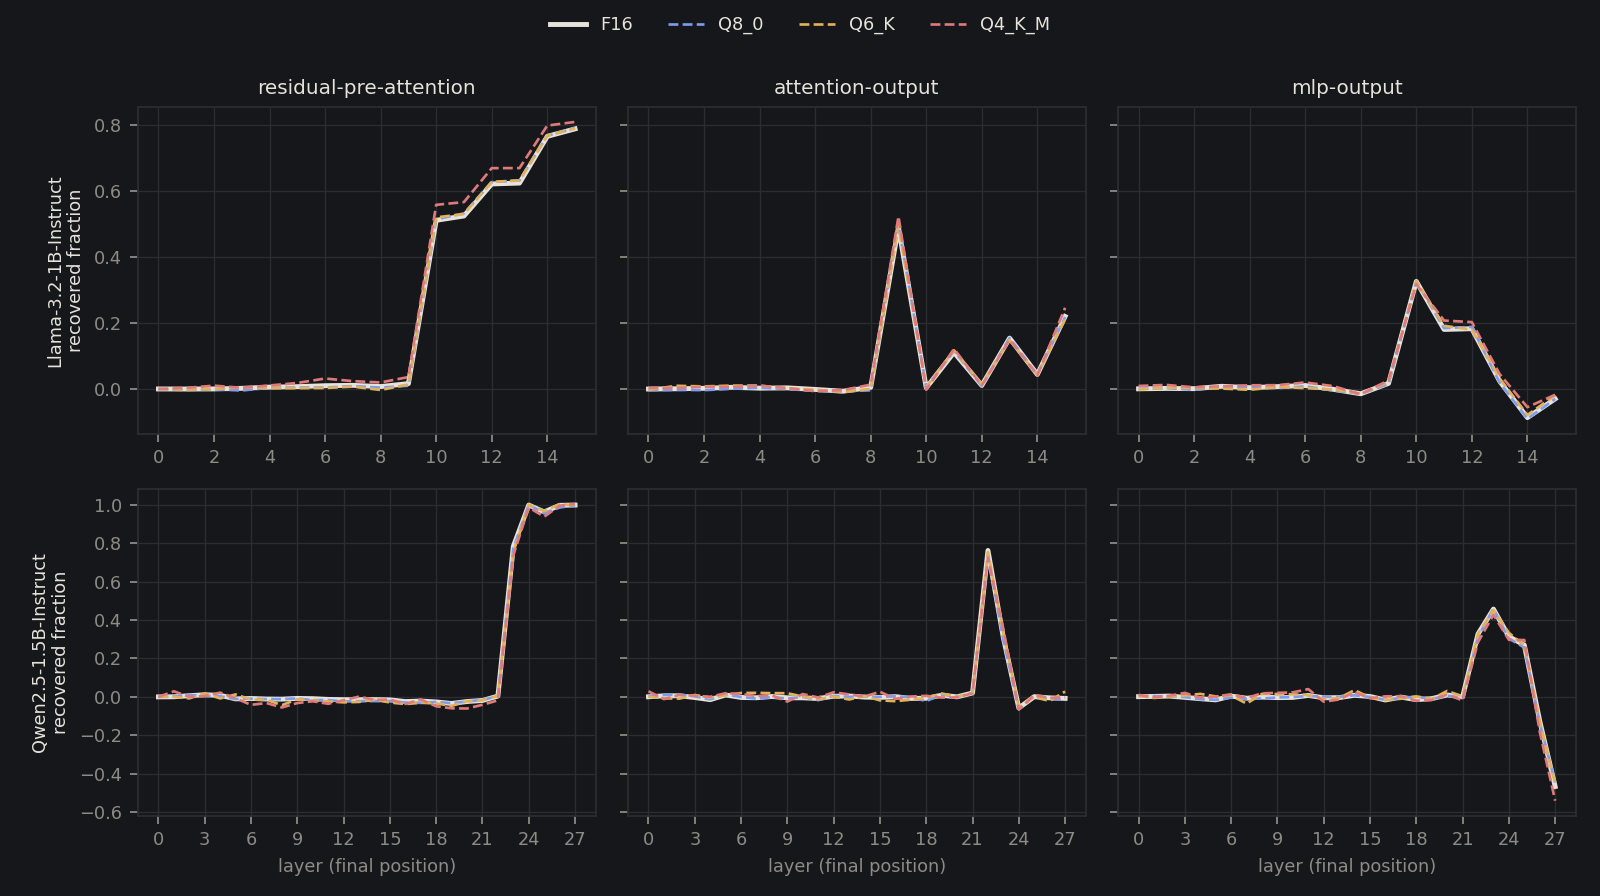
لو حصرنا المقارنة في الأماكن اللي ترجع 5% أو أكثر من الفجوة في F16، التأثيرات تطلع متفقة مرة. منحنى كل مستوى على الـlayers فوق منحنى F16 تقريباً.
| النموذج | المستوى | Spearman، كل الـcandidates (median) | Spearman، الأماكن ≥5% (أسوأ زوج) | أكبر خطأ في الـrecovered fraction | layer التسليم نفس F16 |
|---|---|---|---|---|---|
| Llama-3.2-1B | Q8_0 | 0.90 | 0.997 | 1.6 نقطة | 6 من 6 |
| Llama-3.2-1B | Q6_K | 0.82 | 0.995 | 6.5 نقطة | 5 من 6 |
| Llama-3.2-1B | Q4_K_M | 0.80 | 0.972 | 8.5 نقطة | 5 من 6 |
| Qwen2.5-1.5B | Q8_0 | 0.85 | 0.934 | 3.8 نقطة | 6 من 6 |
| Qwen2.5-1.5B | Q6_K | 0.68 | 0.883 | 4.6 نقطة | 6 من 6 |
| Qwen2.5-1.5B | Q4_K_M | 0.62 | 0.867 | 8.5 نقطة | 6 من 6 |
layer التسليم هي أول layer يرجع فيها الـresidual stream عند آخر موقع نص الفجوة، يعني المكان اللي يوصل فيه الجواب لآخر token. طلعت نفس F16 في 34 من 36 مقارنة، والاثنين الباقية جت قبلها بـlayer واحدة. وأقوى مخرج attention أو MLP طلع نفس F16 في الـ36 كلها.
والفجوة نفسها تتحرك حوالي 5% بالأكثر. الضغط ما غير إيش يعرف النموذجين عن العواصم، ولا فين ينقلون هذي المعلومة.
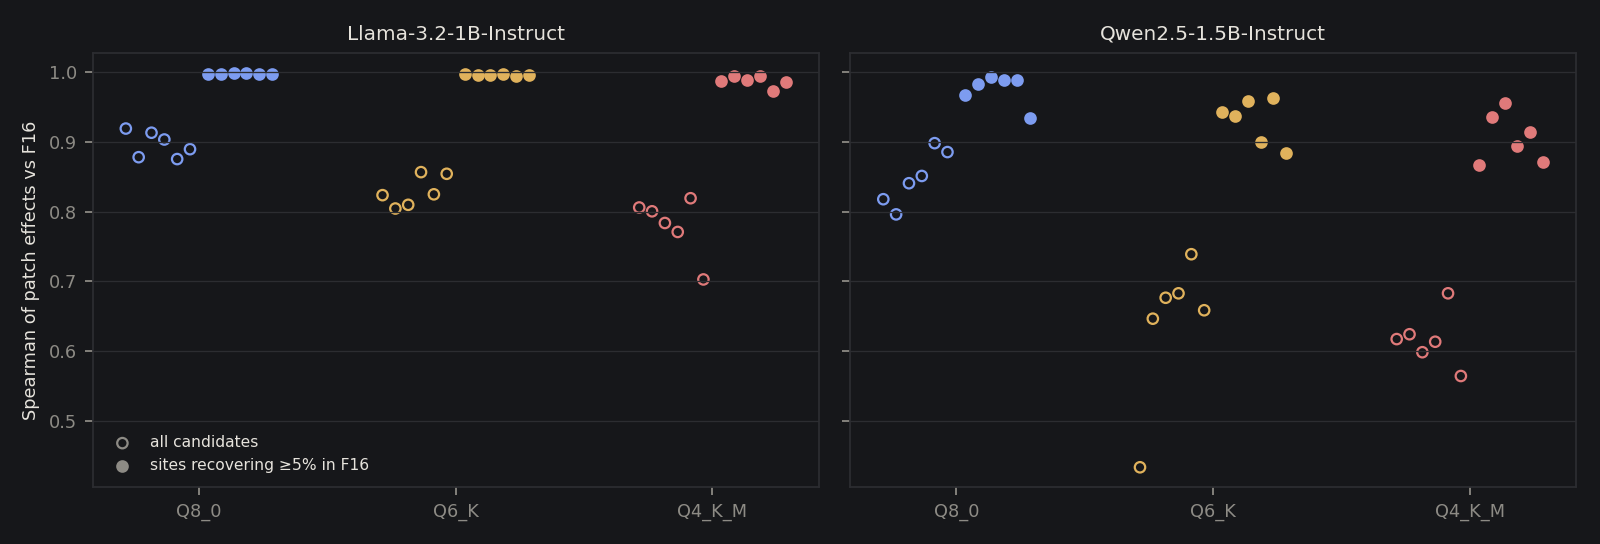
Qwen يتأثر أكثر من Llama. في Q4_K_M أسوأ زوج عنده ينزل إلى 0.87 على الأماكن المهمة، وLlama عند 0.97، والمنحنيات لسه تنقرأ بنفس الطريقة. ومع ست أزواج بس لكل نموذج، ما أبغى أبني على هذا الفرق أكثر من كذا.
في هذي النماذج وهذي المهمة، نسخة Q4_K_M تلقى نفس الأماكن، وأحجام تأثير في حدود نقاط قليلة، ونفس layer التسليم مثل F16. يعني تحديد فين تنحمل المعلومة يصمد مع الضغط.
بس فيه عادتين ما يصمدون. قراءة الترتيب بين التأثيرات الصغيرة هي قراءة ضوضاء. والـrank correlation على كل الـcandidates تسيطر عليه هذي التأثيرات الصغيرة، فيقلل من الاتفاق على المهم، وما يصلح يكون الرقم الرئيسي في مقارنة patching. الأحسن تنشر أحجام التأثير فوق حد معلن.
والقاعدة اللي كتبتها مسبقاً وقعت في هذي الغلطة بالضبط. وهي لسه في مجلد الدراسة زي ما كتبتها، وجنبها التشخيصات اللي انضافت بعد أول تشغيل، ومكتوب عليها إنها استكشافية.
التصميم والسكربت والنتائج والرسوم والـhashes لكل bundle موجودة في research/quant-attribution. والتصميم انحفظ في git قبل أول تشغيل.
python research/quant-attribution/run_study.py run --ember target/release/ember --out runs/quant-attribution
python research/quant-attribution/run_study.py analyze --out runs/quant-attribution --results results --figures