تخيّل عندك معلومة في المصدر باسم M3. المطلوب نمرّر معلوماتها لنموذج ثاني، ونخليه يرجّع الـID الصحيح: الحرف والرقم. النموذج الثاني ثابت؛ اللي ندرّبه هو الواجهة اللي توصّل له المعلومة.
الـprobe قدر يقرأ أغلب الـIDs اللي ما شافها في التدريب. بس لما مرّرنا المعلومة للـreceiver الثابت، نجح ID واحد بس: M3. وكملنا التدريب، فتحسن الأداء على التدريب واختفى النقل.
هذي نتائج مكتملة على مهمة صغيرة من حرف ورقم. مو تقييم للغة العربية، ولا دليل على نقل قوي يعمم. والـIDs الثمانية سبق دخلت في التقييم والتصميم؛ مو test set بكر.
مسار الالتقاط والتدخل وحفظ الـbundles في Ember يساعدنا نفحص تجارب استخدام المعلومة ونعيد تشغيلها.
Probe: متنبئ منفصل ندرّبه يقرأ الـID من features محفوظة من النموذج.
Receiver: النموذج الثابت اللي نطلب منه يطلع الـID. نوصل له features المصدر عن طريق reader ندرّبه.
النقل: الـreceiver يجاوب صح على تركيب حرف ورقم كامل ما دخل في مجموعة التدريب الإيجابية.
ندرّب على IDs مألوفة، وبعدها نختبر تركيبات كاملة من حرف ورقم تركناها خارج التدريب.
التدريب فيه 56 ID، ولكل واحد أربعة استعلامات. المجموع 224 صف تدريب.
البنك التشخيصي فيه ثمانية IDs، ولكل واحد أربعة استعلامات. يعني 32 حالة في كل شرط، بس ثماني هويات مختلفة، مو 32 هوية مستقلة.
الـsender يوفر features من الـhidden states، ونمرّرها في تمثيل مضغوط من 64 بُعد. ذاكرة الـIDs المختارة هنا تجهيز للتطوير. لسه ما اختبرنا الربط على جدول مصدر كامل أو التقاط جديد من المصدر.
قراءة الـID بالـprobe، والوصول له بتدريب oracle مباشر، ونقله للـreceiver ثلاثة اختبارات منفصلة. كل واحد يحتاج دليله.
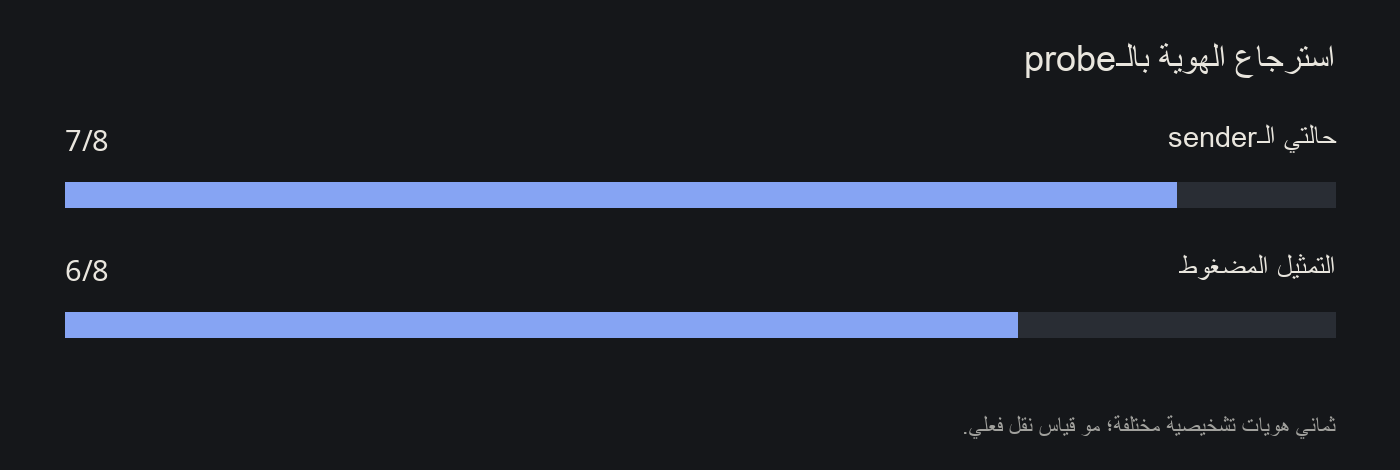
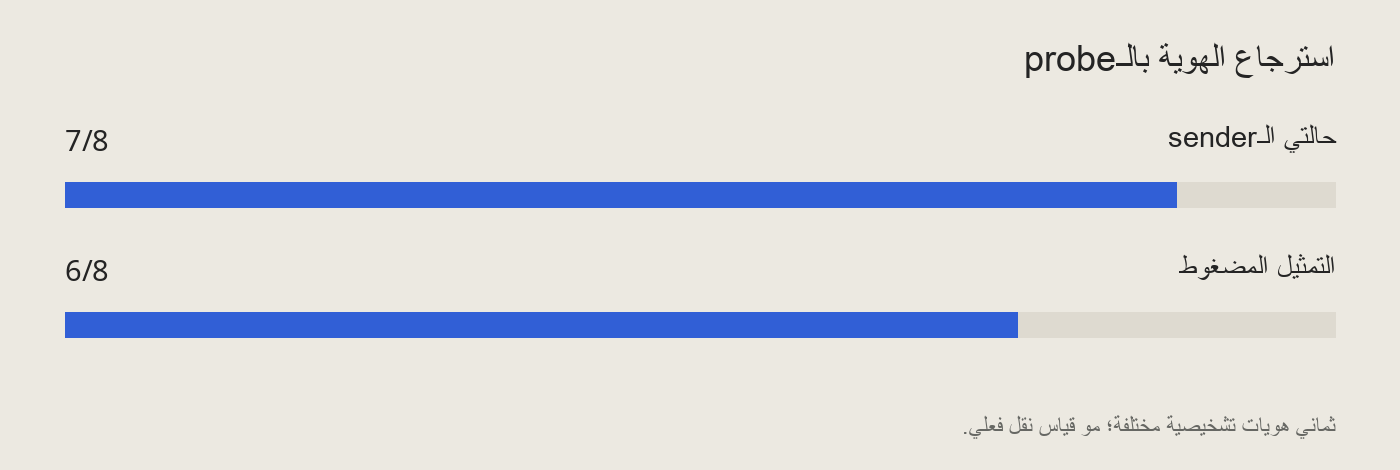
الـridge probe الثابت عمّم على أغلب الهويات التشخيصية.
قرأ 7/8 من حالتي الـsender، و6/8 من التمثيل المضغوط. الاثنين تدربوا على الـ56 ID بس. ما استخدمنا labels تشخيصية أو oracle codes كأهداف تدريب.
لما نترك ID كامل من التدريب كل مرة ونختبره، النتيجة 56/56 من حالات الـsender. بعد الضغط صارت 44/56.
ومع إزاحة labels التدريب كضابط null، النتيجة التشخيصية صارت 1/8 و0/8 بالترتيب.
تطبيقان مستقلان بـNumPy وTorch اتفقوا ضمن حدود الخطأ المسجلة. التوقعات الأساسية كانت نفسها.
A0 انقرأ صح قبل الضغط، وغلط بعده. A2 كان غلط من الـsender أصلاً. هذا يحدد أخطاء القارئ هذا؛ ما يثبت إن الضغط مسح معلومات الهوية.
الواجهة المتدرّبة خلت الـreceiver الثابت يجاوب صح على M3. الهويات التشخيصية السبعة الباقية فشلت.
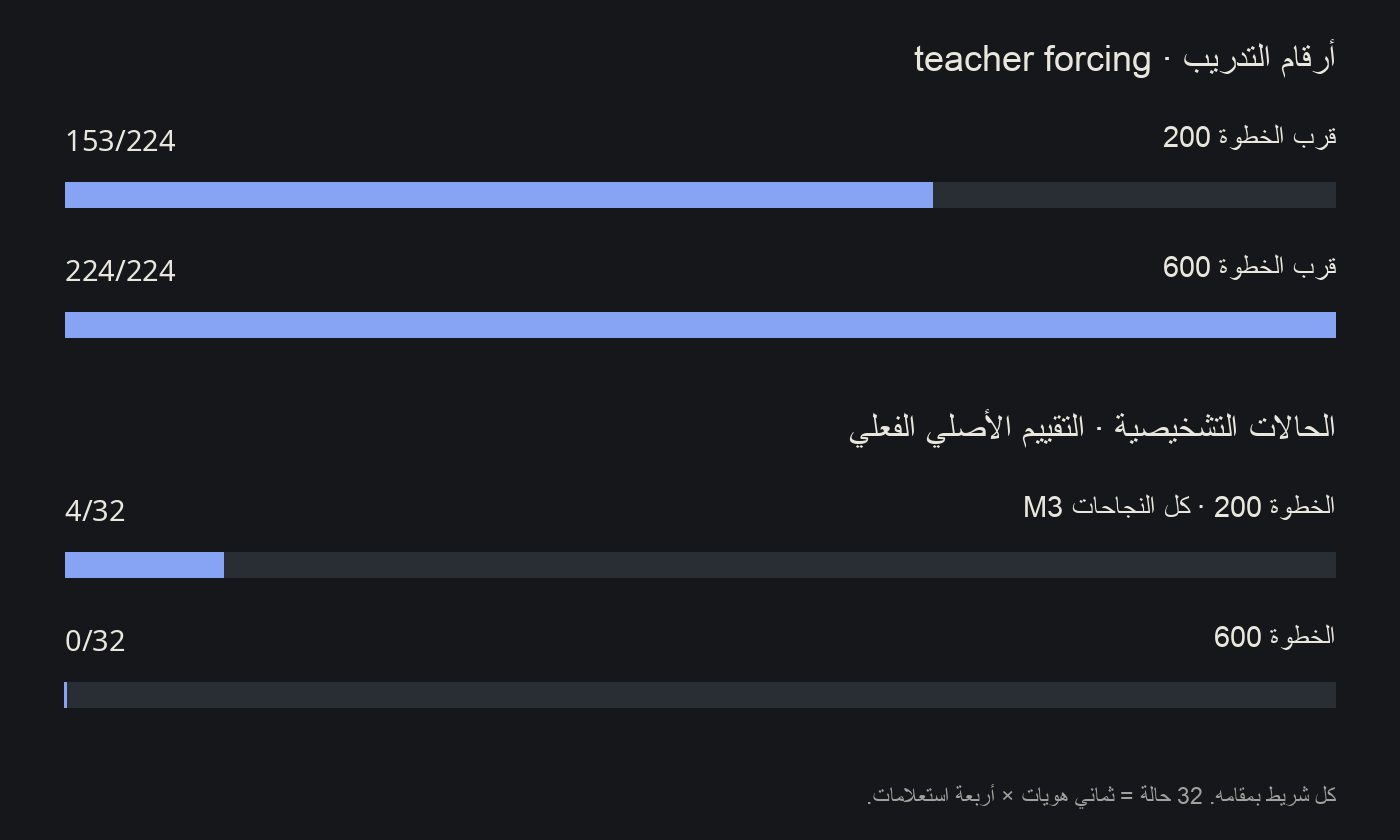
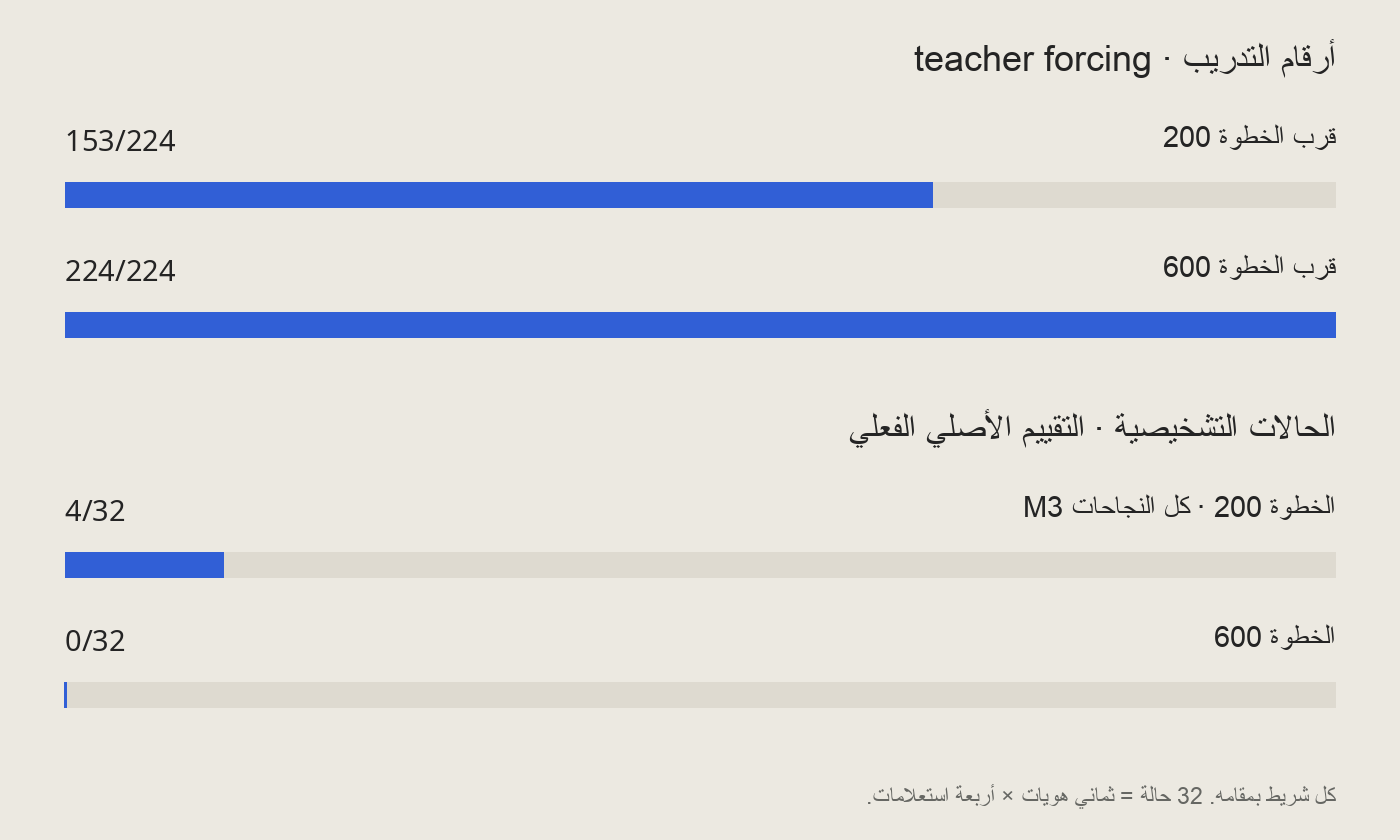
النتيجة 4/32 في كل شرط: الأصلي، واتباع المصدر المنقول، وتغيير الربط. الاستعلامات الأربعة الناجحة كلها تخص M3.
الضوابط المألوفة عدّت. الأصلي جاب 32/32، واتباع المصدر المنقول 32/32، وتغيير الربط 31/32.
غيّرنا reader.value.weight بس. التدريب كان 200 خطوة Adam محددة مسبقاً، على الـ224 صف تدريب.
الـsender والـreceiver والـrouting وباقي مدخلات الجسر وعدد المعاملات بقيت ثابتة. ما فيه codebook وقت الاستدلال أو بحث عن جواب الـID التشخيصي.
التقييم المشترك والتقييم التسلسلي المقيد اتفقوا. التسلسلي يختار من 16 بادئة وثمانية أرقام؛ مو توليد حر. بوابات النجاح العددية والمقارنات المزدوجة المسجلة مسبقاً فشلت.
الـprobe قرأ 6/8، والـreceiver نجح في هوية واحدة. هذي عمليتان مختلفتان، والفجوة بينهم ما تحدد آلية الفشل.
لما كملنا نفس التدريب، اختفى النجاح التشخيصي الوحيد عند الـreceiver.
أعدنا معاملات الخطوة 200 وحالة Adam بالضبط، ثم كملنا 400 تحديث. النتائج التشخيصية نزلت من 4/4/4 إلى 0/0/0 في الشروط الثلاثة. النتائج المألوفة بقيت 32/32/31.
الـtraining loss المسجل قبل التحديث نزل من 0.5465 إلى 0.0954.
مع teacher forcing، دقة الأرقام طلعت من 153/224 إلى 224/224. الحروف كانت أصلاً 224/224.
هذي قياسات تدريب قرب نقطتي النهاية. ما تقيس النقل الفعلي، ولا تثبت تقارب رياضي.
هوامش إجابة الـreceiver نزلت لستة من الثمانية. هامش M3 الموجب الصغير صار سالب. في المسار هذا، دقة التدريب الكاملة جات مع نقل أسوأ.
لو اخترنا checkpoint ثاني من الدرجات التشخيصية، نكون استخدمنا الاختبار للاختيار. اختيار الخطوة يحتاج validation من IDs التدريب بس. شغل الـfour-fold المنفصل ما كان عنده نتيجة مجمعة عند تاريخ الملاحظة.
فحوص الإعادة والواجهة عدّت. هذا يدعم قراءة النتيجة كضعف نقل تحت الـmapping اللي اختبرناه.
نقطة البداية والدرجات التاريخية والحالات المكررة رجعت مطابقة. فحوص native/render parity والتقييم المباشر والـrouting وعقد حالة الـreader المحفوظة عدّت.
فحوص إعادة بناء الأوزان والدرجات المستقلة عدّت كمان. Hash الـreceiver ما تغير، وحالته رجعت كما كانت.
الفحوص تثبت آلية التشغيل المختبرة. بس الثمانية IDs اللي سبق استخدمناها ما تمثل فهم اللغة عموماً.
ملاحظات الصرف تسأل إذا الـprobe يعمم خارج الكلمات المألوفة. هنا أضفنا اختبار للـreceiver: ستة IDs تنقرأ بعد الضغط، وID واحد ينتقل.
عشان كذا نفصل نتيجة الـprobe عن سلوك النموذج في التقرير. ادعاء إن النموذج يستخدم المعلومة يحتاج تدخل سلوكي. المهمة الصغيرة هذي ما تضيف نتيجة جديدة عن اللغة العربية.