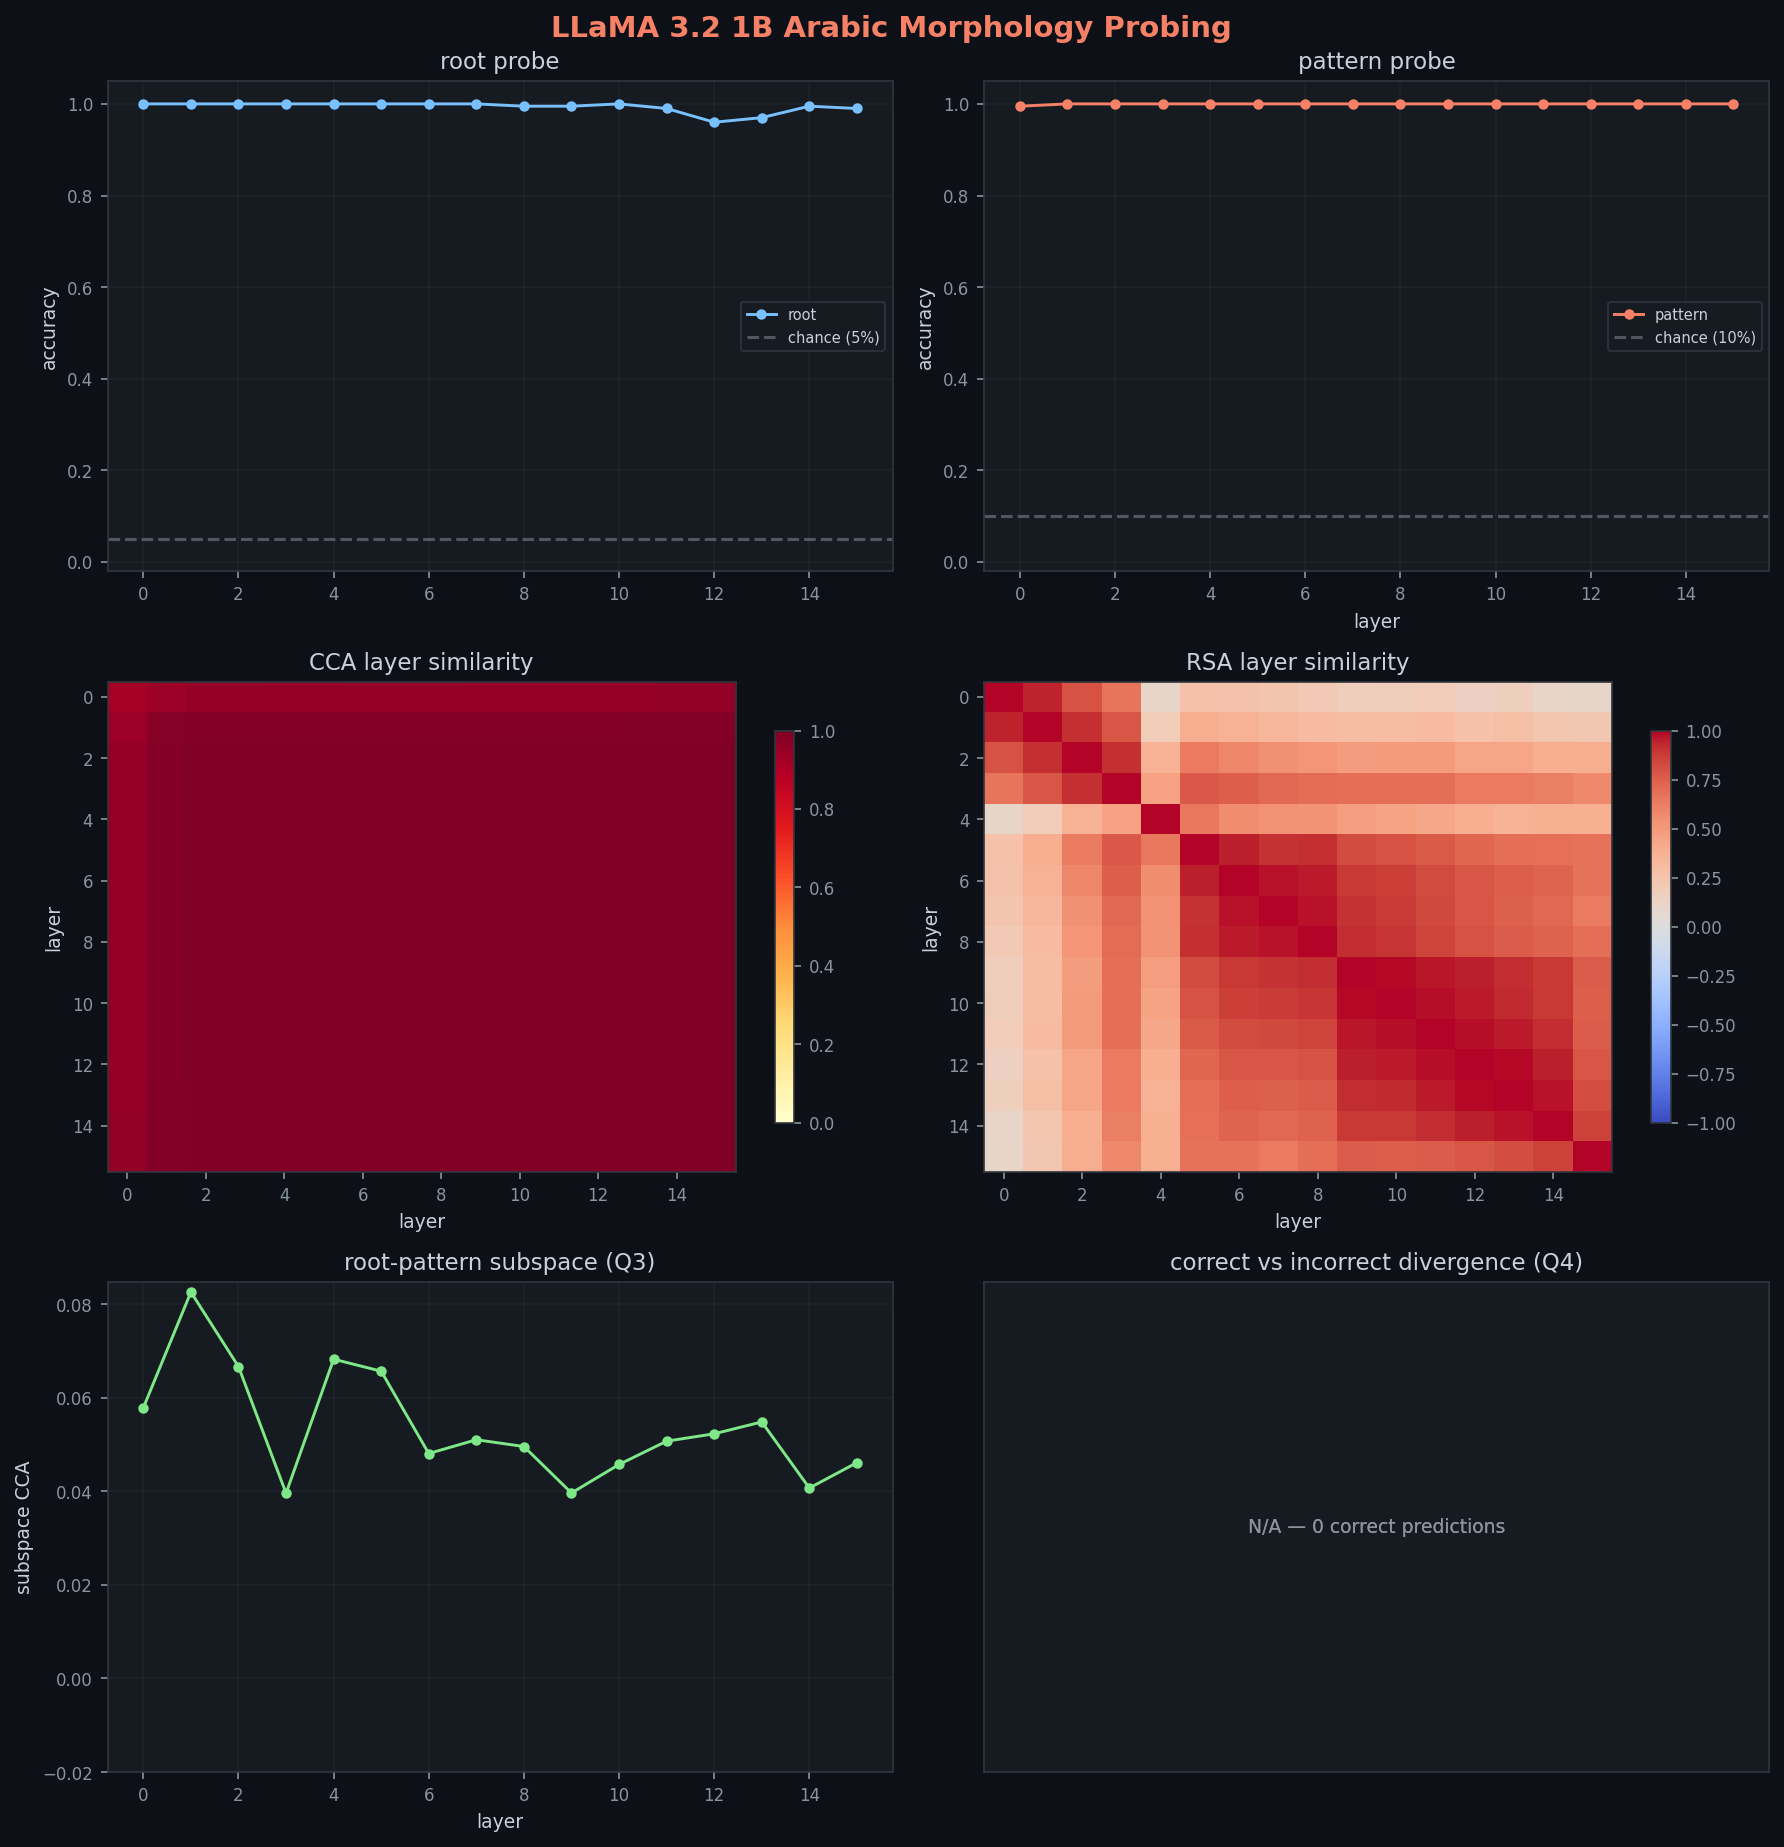
الـprobes المحلية المصححة قرأت labels مكتوبة صراحة في الـprompts. دقة الوزن وصلت 99.5% في الطبقة 0 لتشغيل 1B، و100% بعدها. الضوابط هذي تكشف الـlabels من البداية، فما تثبت تركيب الجذر والوزن العربي.
ورقة Alakeel et al. (2026) خلّت سؤال مفتوح: GPT-4o يوصل 97% في توليد الجذر والوزن العربي على nonce roots، مع إنه عنده أسوأ محاذاة tokenizer في الدراسة (17% boundary precision). بالمقابل، ALLAM عنده أفضل محاذاة tokenizer، لكنه ينهار لـ 20% في نفس المهمة.
جودة الـ tokenizer ما تكفي تتنبأ بالكفاءة الصرفية. طيب إيش اللي يتنبأ؟
الورقة السلوكية تحفزنا نفحص التمثيلات الداخلية. بس التشغيل المؤرشف هنا يجاوب سؤال أضيق: إيش يقدر الـprobe يسترجع من متغيرات مكتوبة في الـprompt؟ بما إن الـlabels مكشوفة، ما نقدر نعتبره تفسير لآلية الصرف.
استخدمت ember، وهو inference engine مكتوب من الصفر ويعطي وصول مباشر للـ hidden states بعد كل transformer block، عشان أفحص LLaMA 3.2 1B و LLaMA 3.2 3B على مهمة nonce root-pattern.
عندنا 20 جذر ثلاثي مخترع من بيانات Alakeel × 10 أوزان عربية = 200 محفز، وكلها مكتوبة بحروف لاتينية عشان يكون الـ probing آمن مع ASCII. نتائج 8B من التشغيل الأول مؤرشفة تحت إلى أن نعيدها على جهاز أقوى.
استخدمت أربع طرق تحليل:
ملاحظة منهجية: الـ probes تقيس المعلومة اللي نقدر نسترجعها من الـ hidden states، مو المعلومة اللي يستخدمها النموذج سببياً وقت التوليد. الفصل الخطي مجرد حد أدنى للبنية الموجودة؛ ما يعني إن النموذج يعتمد عليها في المخرج.
التشغيل المصحح يستخدم تقسيمات مغلقة مناسبة للمهمة: فحص الجذر يحجز الأوزان خارج التدريب، وفحص الوزن يحجز الجذور خارج التدريب. الصياغة القديمة لفحص الجذر مع جذور محجوبة ما كانت صالحة، لأنها تطلب من المصنف يتوقع جذور ما شافها في التدريب.
التشغيل المصحح لـ 1B و 3B لسه يطلع The لكل محفز: 0/200. الـ hidden states تحتفظ بمتغيرات الجذر والوزن المكتوبة صراحة في الـ prompt، بس هذا لسه مو دليل كافي على صرف عربي داخلي.
الخطوة الجاية لازم تفرق بين استرجاع متغيرات الـ prompt وبين الحساب الصرفي فعلاً.
generate_stimuli.py        → stimuli/nonce_root_pattern.json  (200 stimuli)
ember --probe              → activations.npy + correctness.json
train_linear_probe.py      → probes.npz           (root + pattern accuracy per layer)
cca_analysis.py            → cca.npz              (layer similarity + disentanglement)
rsa_analysis.py            → rsa.npz              (representational similarity)
divergence_analysis.py     → divergence.npz        (correct vs incorrect gap)
plot_results.py --dark     → probe_results.png     (3x2 figure)
كل الكود موجود في مستودع ember. التشغيل المصحح لـ 1B و 3B صار محلياً. رسم 8B باقي كأرشيف للمقارنة، بس ما أعدناه بالتقسيم المصحح لأن الجهاز المحلي ما يشغله بثبات.
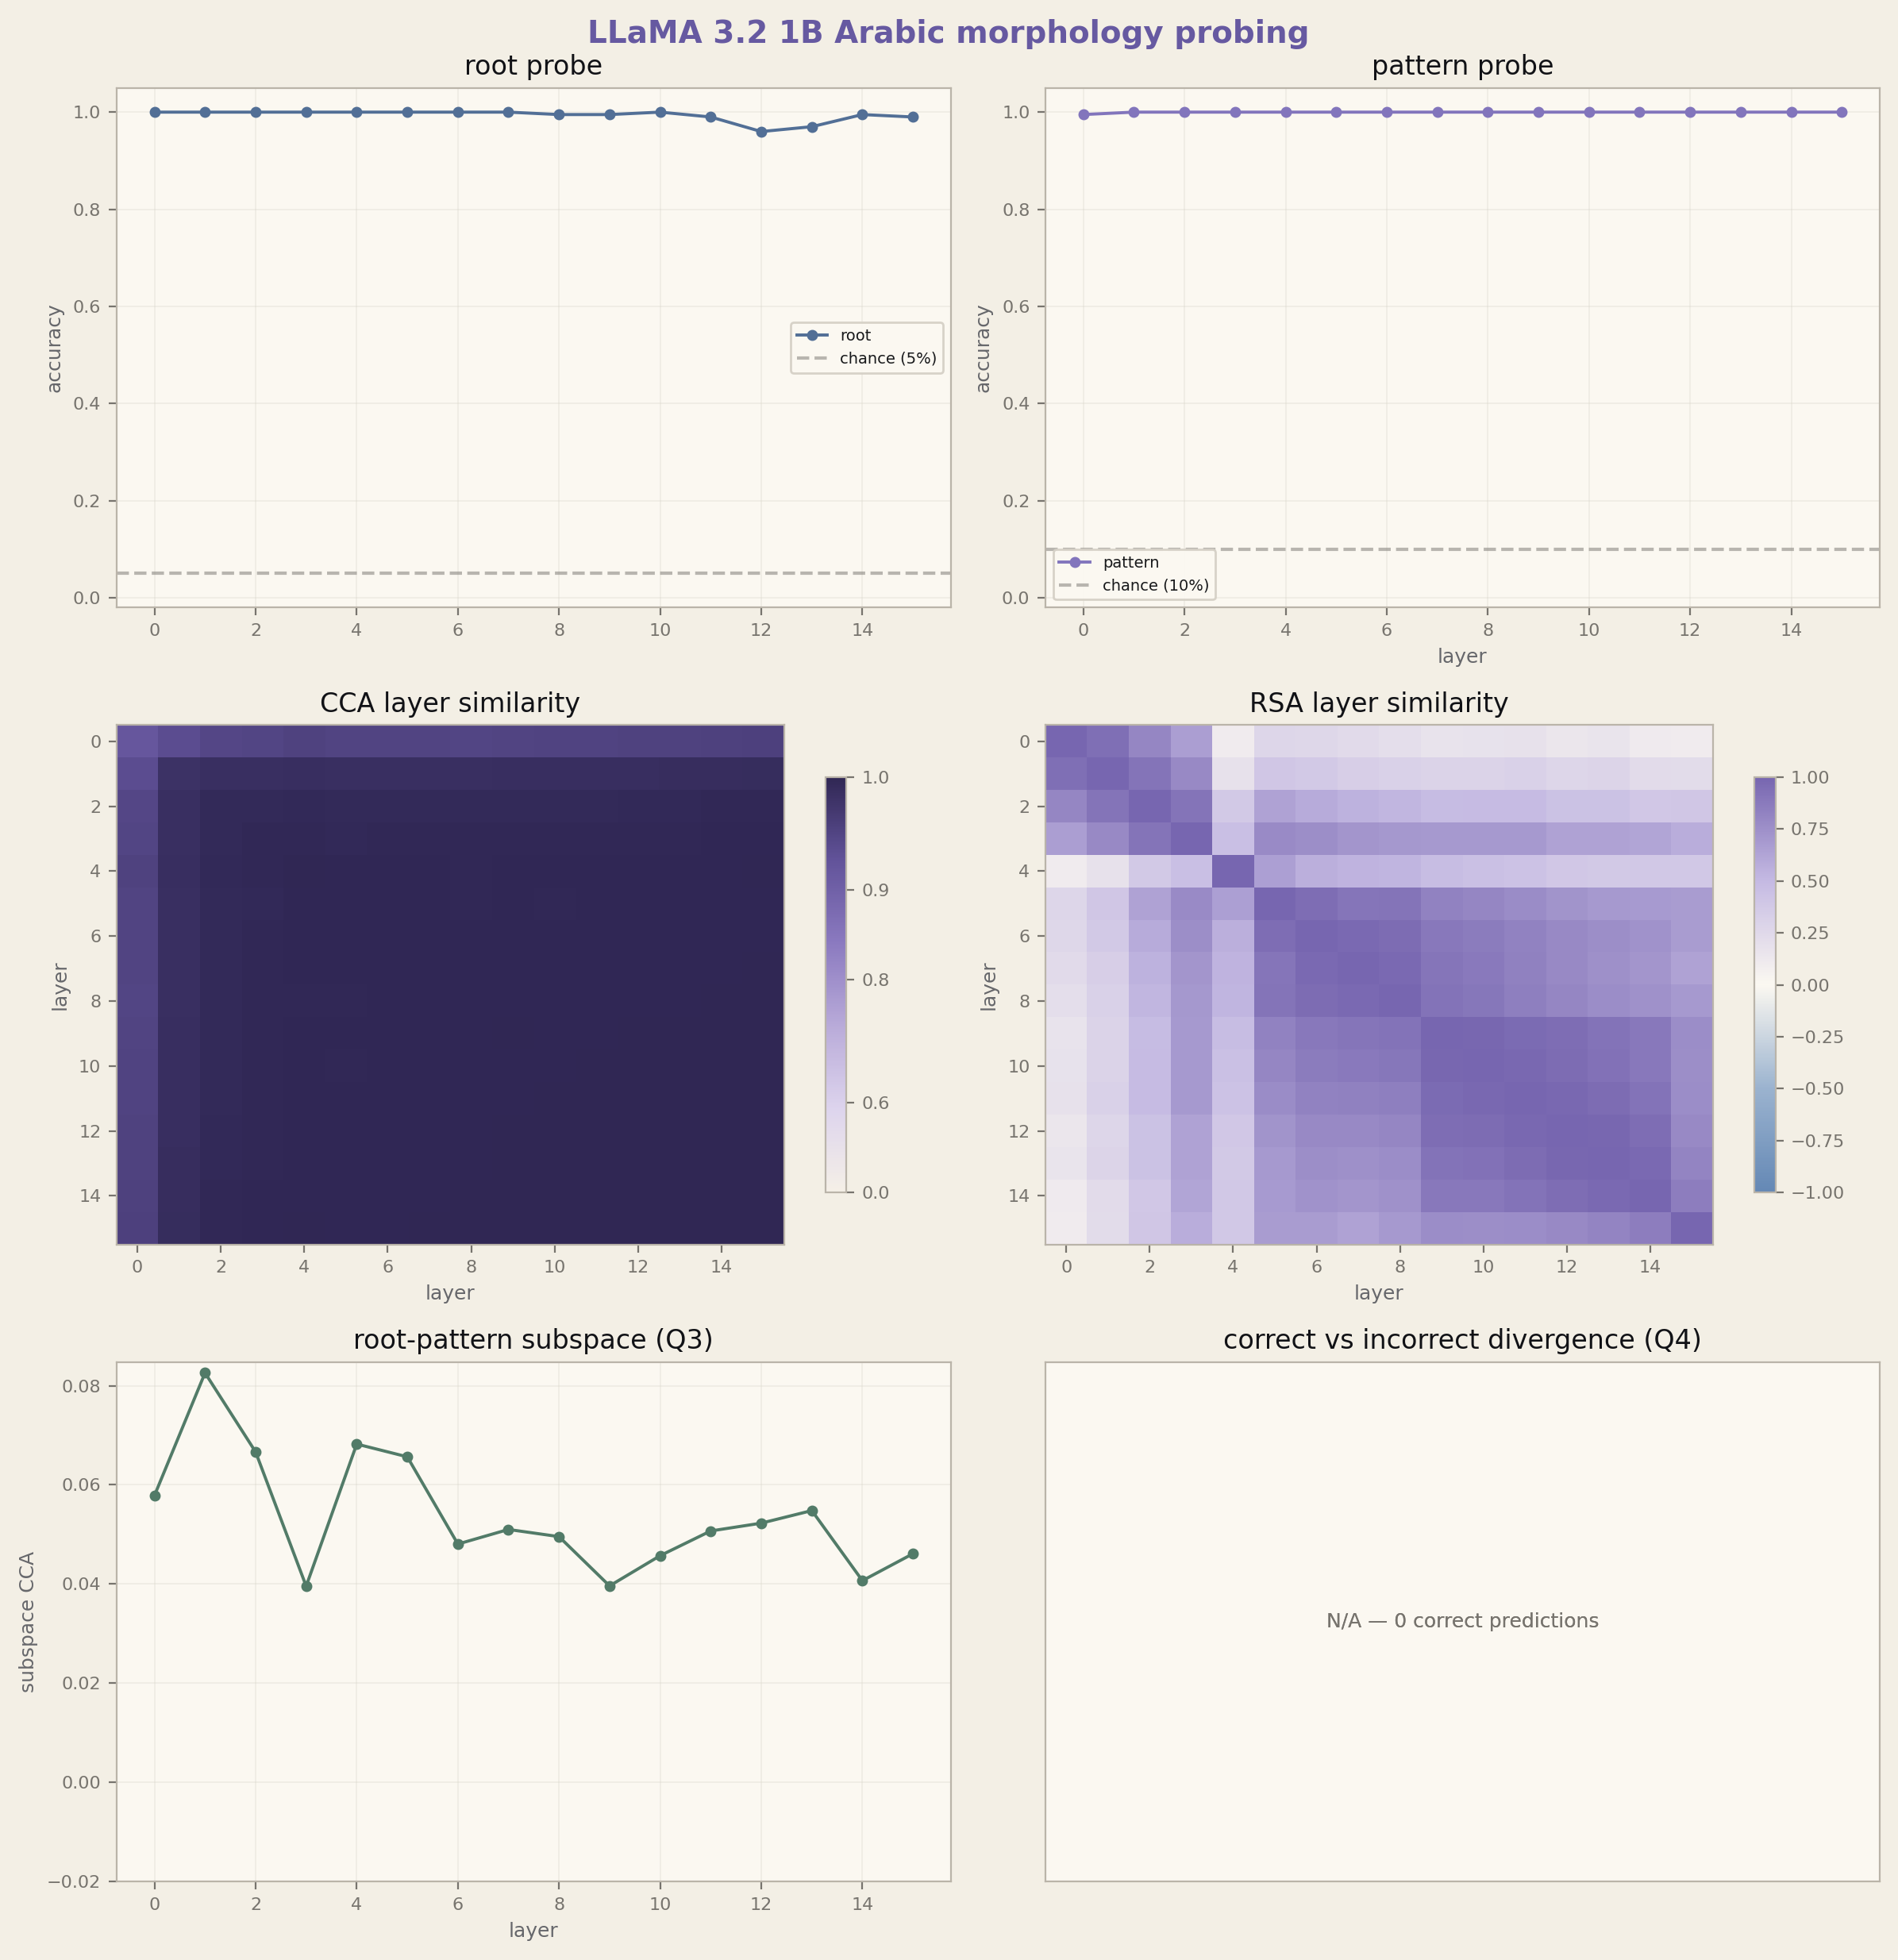
هوية الجذر تنفك بسهولة في كل طبقة (دقة 96-100%، ومنحنى شبه مسطح). معلومة الجذر تظل قابلة للاسترجاع خطياً عبر عمق النموذج كله.
هوية الوزن تنفك خطياً من الطبقة 0 تحت التقسيم المصحح اللي يحجب الجذور: 99.5% في الطبقة 0، وبعدها 100%. منحنى "اكتساب الوزن" القديم ما يصمد بعد تصحيح منطق التقسيم.
CCA للتشابه الذاتي يبدأ عند 0.92 (الطبقة 0) ويتشبع بسرعة (0.98 عند الطبقة 1، و 0.999 عند الطبقة 4). يعني التمثيلات تستقر بسرعة. RSA لسه يكشف انتقالاً هندسياً مبكراً، بس ما عاد يفسره كلحظة صار فيها الوزن قابلاً للاسترجاع.
root-pattern subspace CCA منخفض من البداية في الإعداد المصحح، تقريباً بين 0.04 و 0.08 عبر الطبقات، وأدناه 0.040 عند الطبقة 3. أوزان فحص الجذر والوزن منفصلة بقوة من البداية.
هنا تبدأ السالفة تصير غريبة.
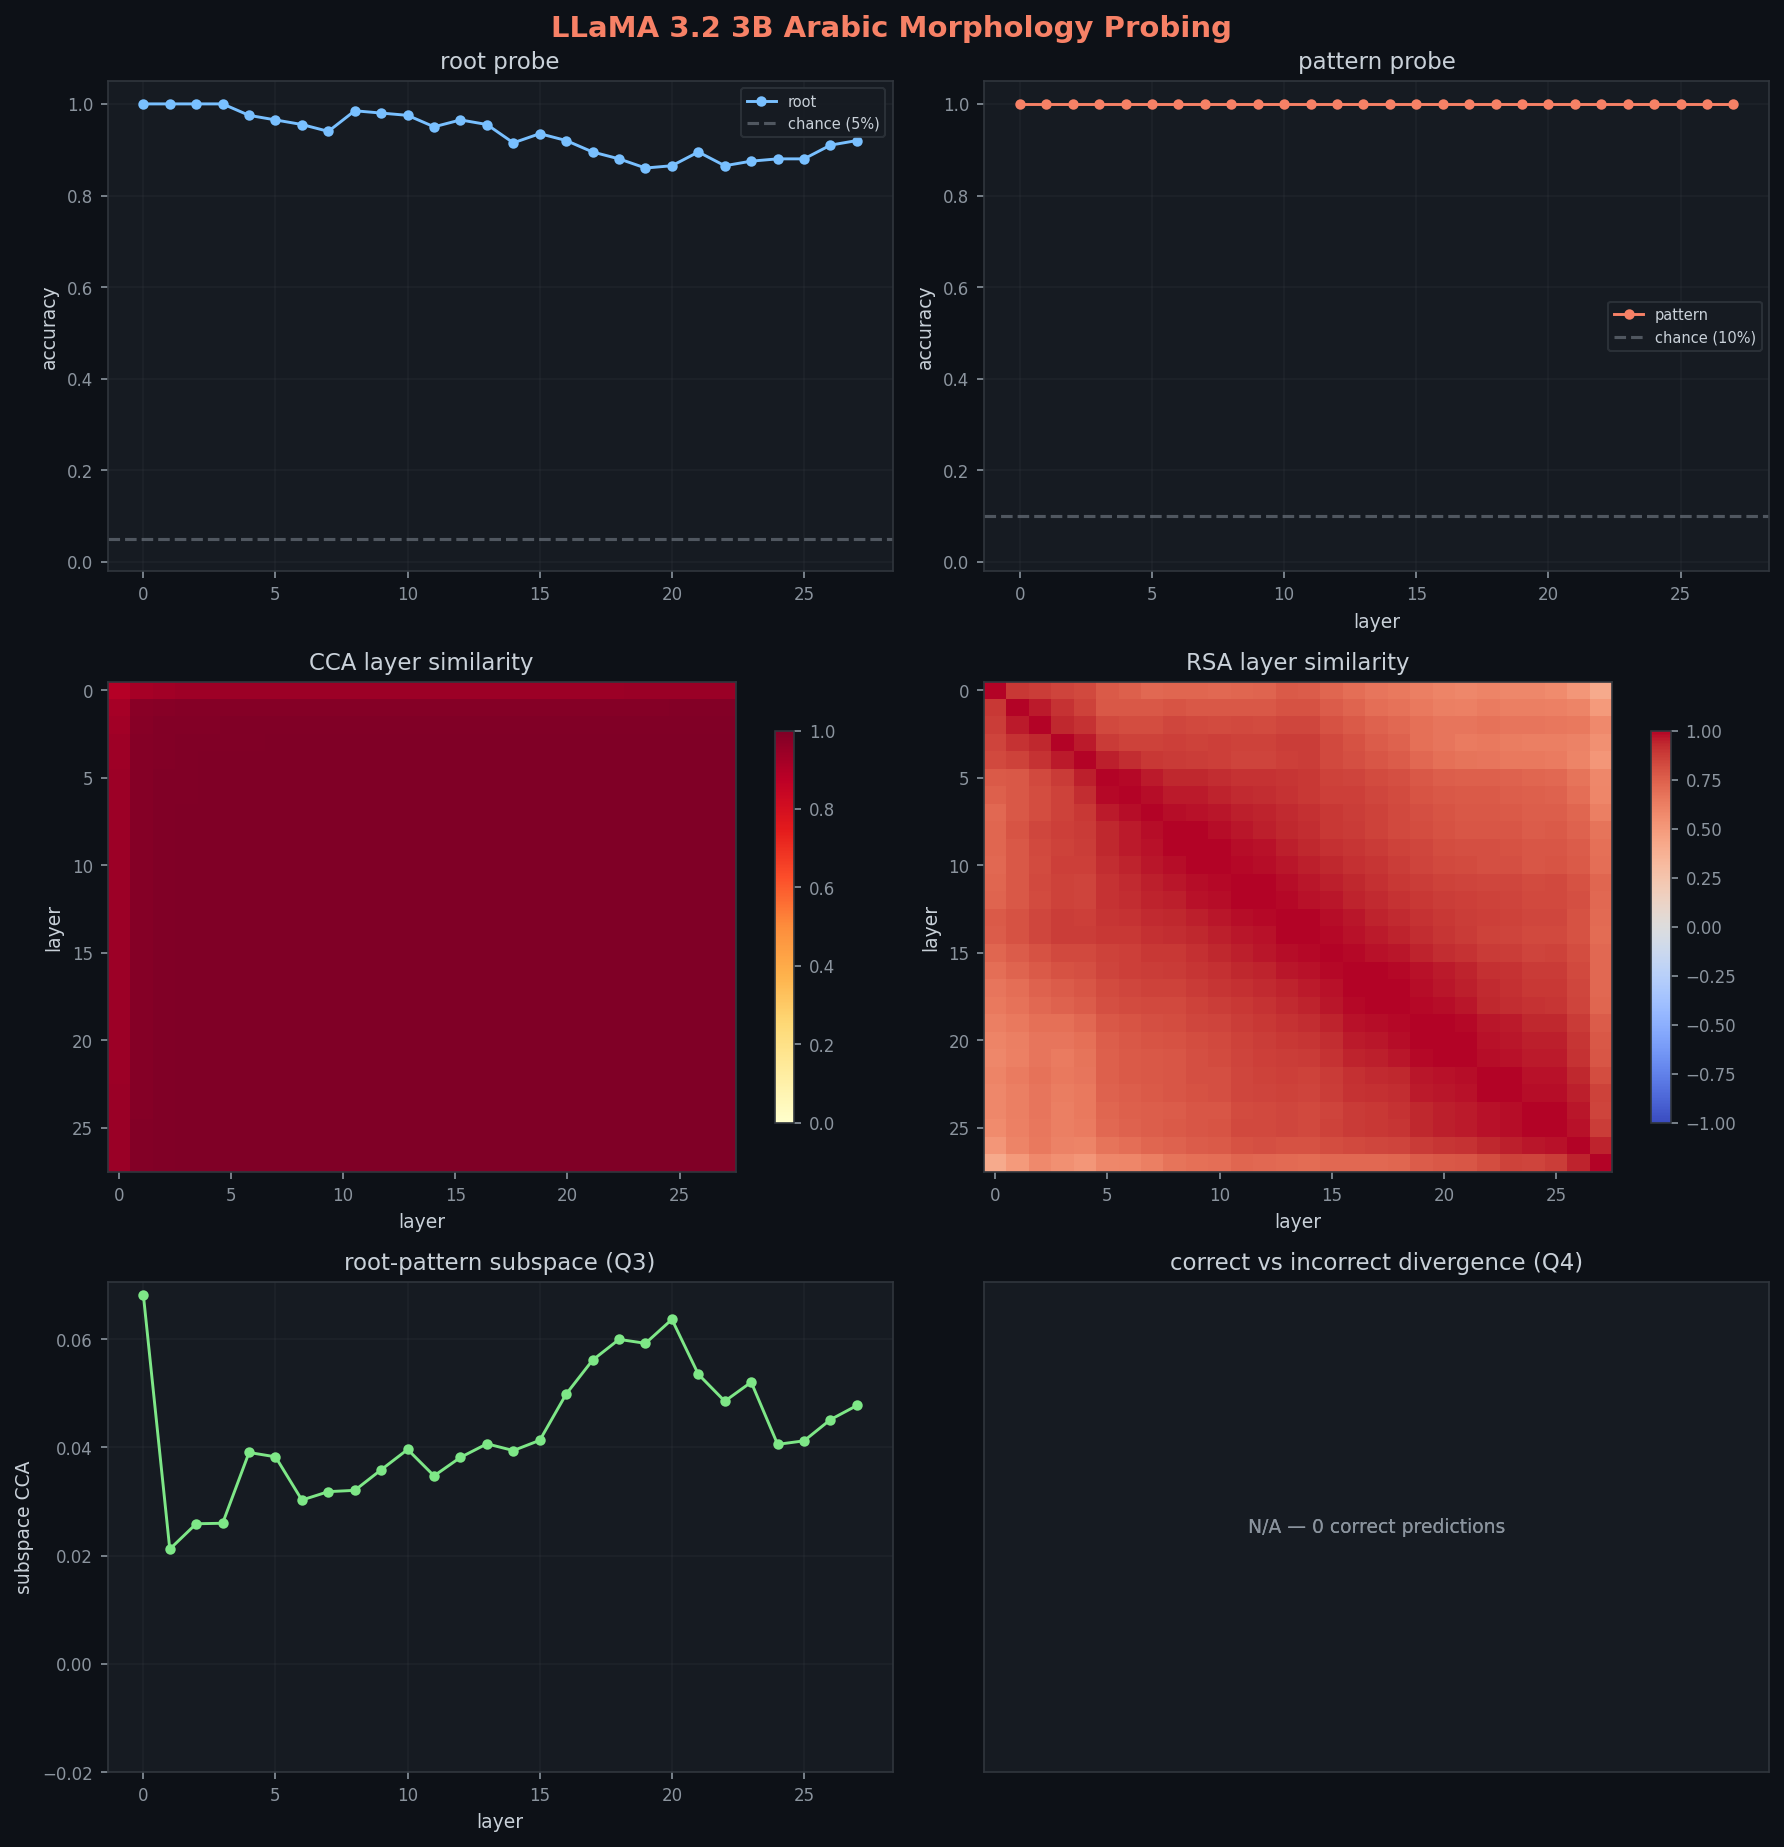
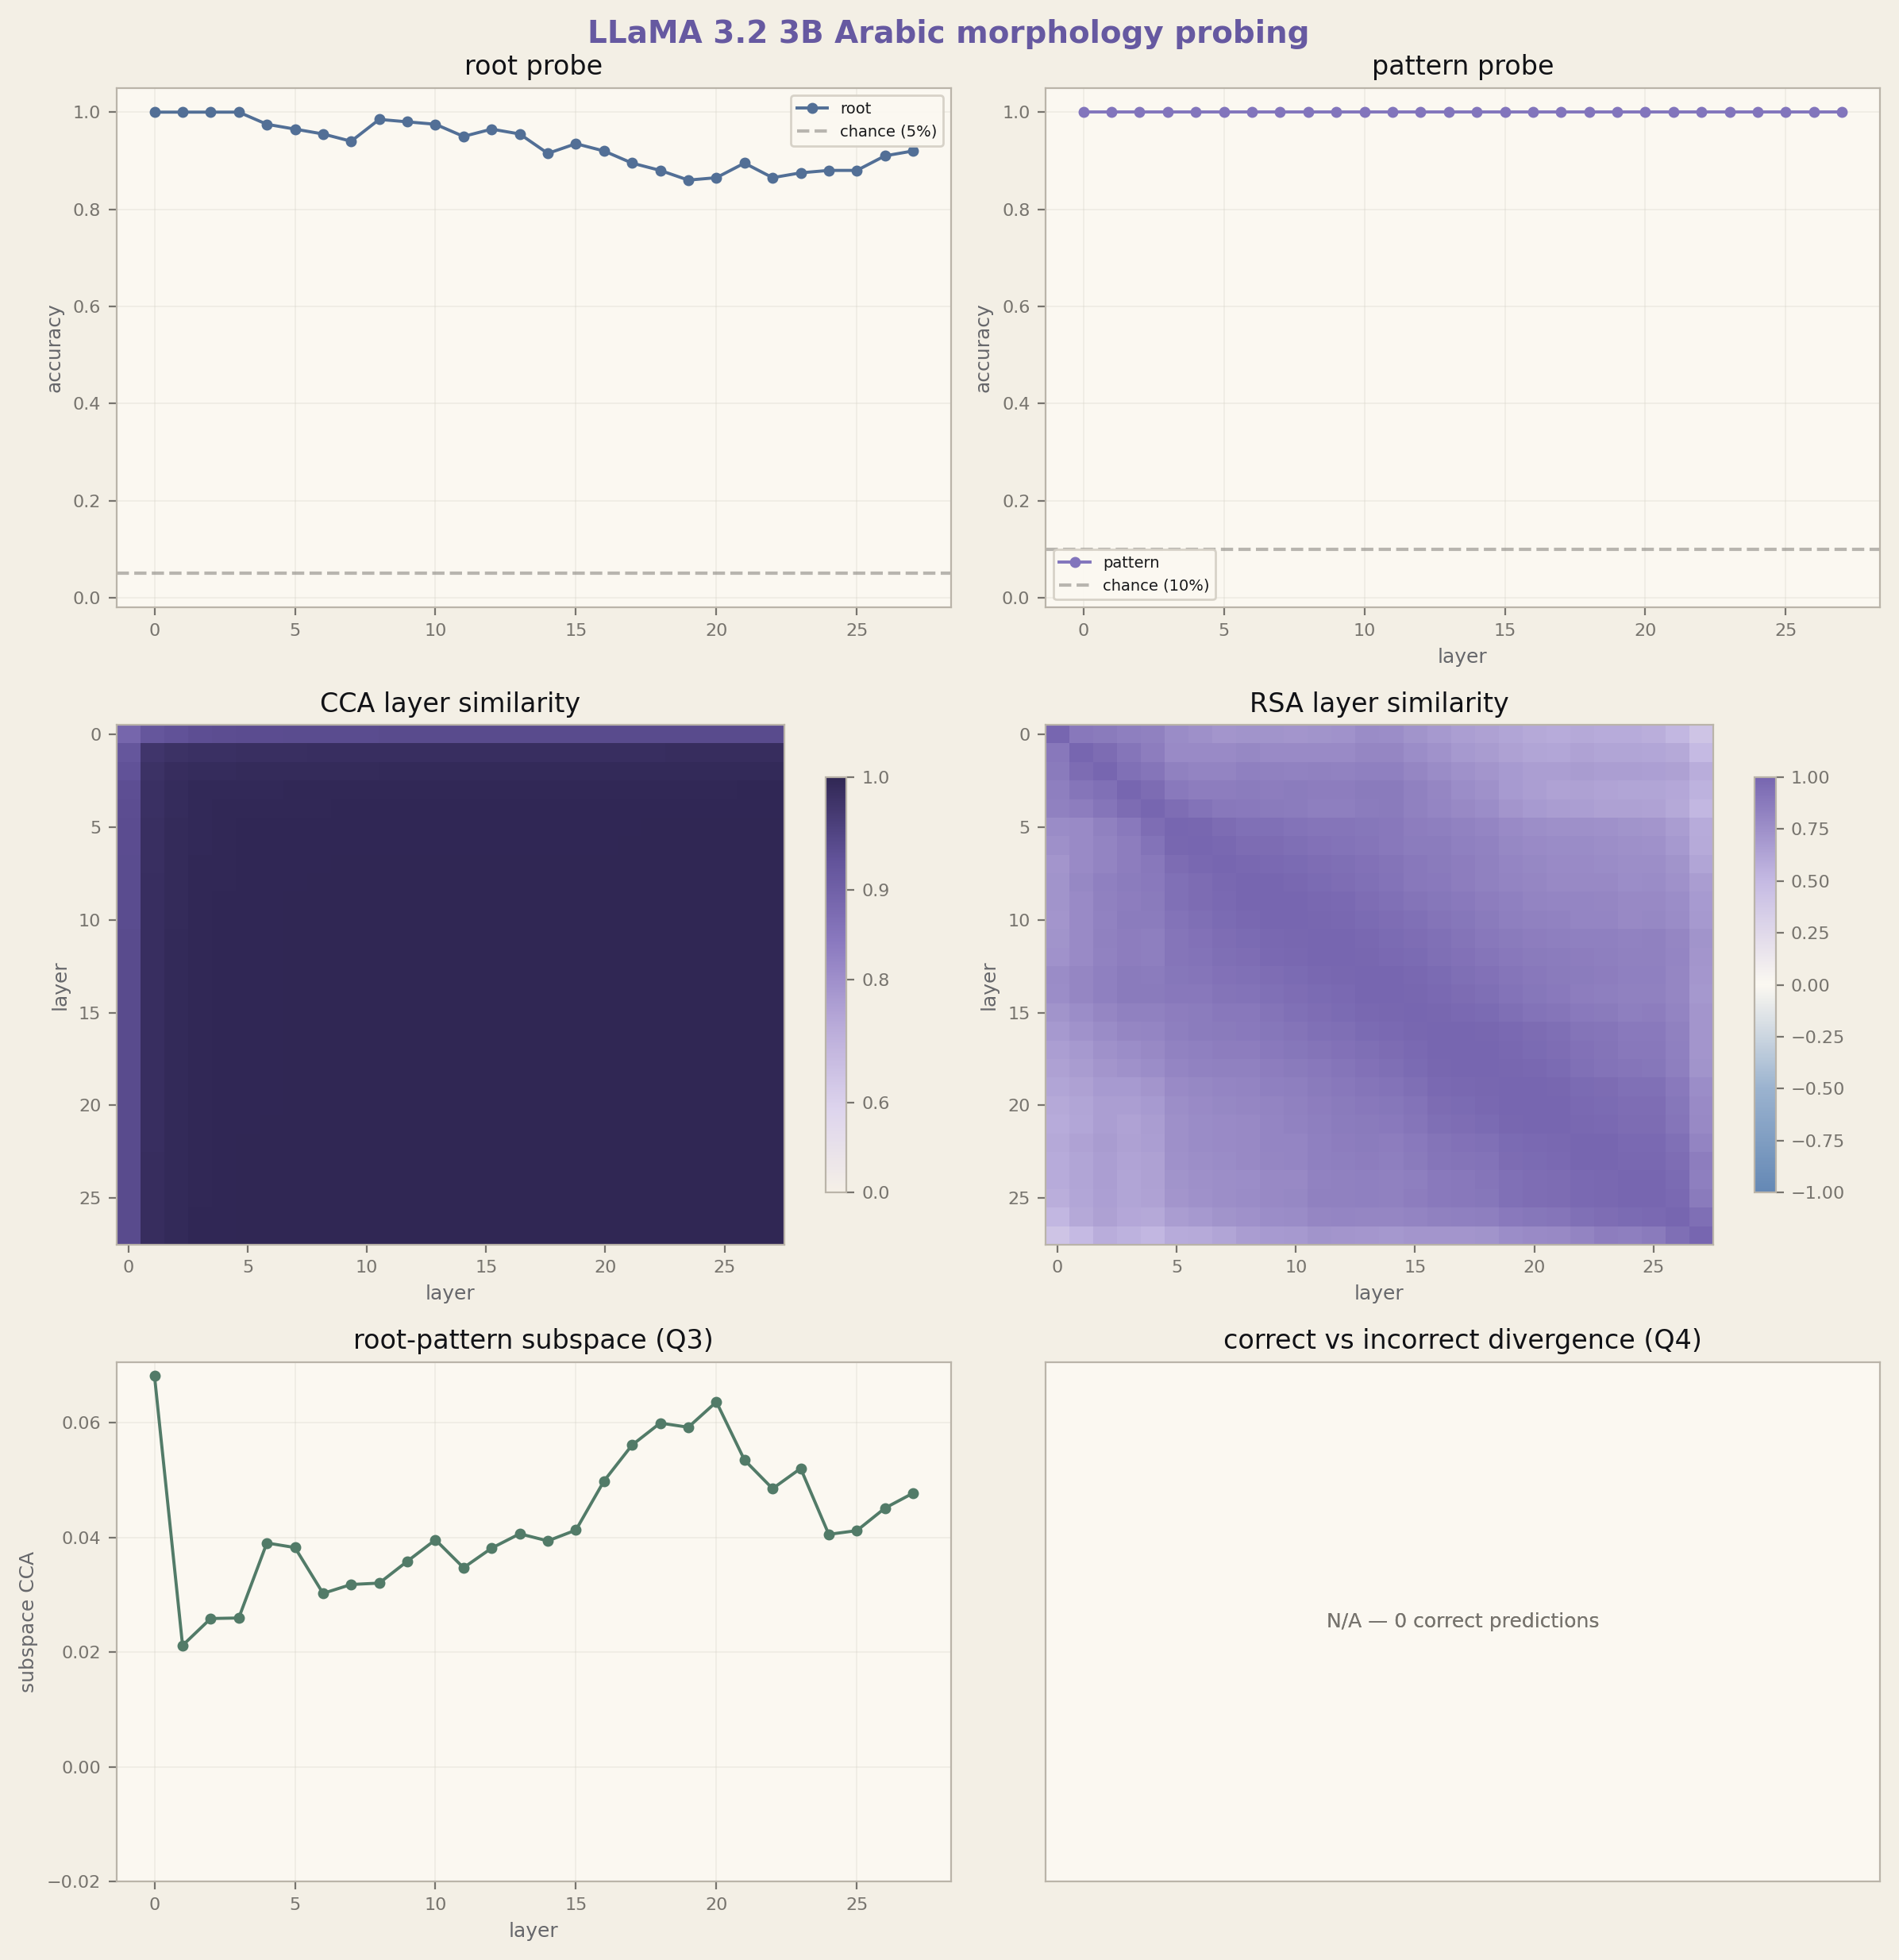
هوية الجذر لسه تطلع معها نزلة على شكل U، بس القاع المصحح أضعف من النسخة الأولى. تبدأ عند 100%، وتتآكل في الطبقات الوسطى، وتوصل القاع عند 86% في الطبقة 19، ثم تتعافى جزئياً إلى 92% في الطبقة الأخيرة.
هوية الجذر تصير أقل قابلية للوصول الخطي في الوسط، قبل ما ترجع جزئياً في أعمق الكتل.
هوية الوزن ثابتة تماماً عند 100% في الطبقات الـ 28 كلها. الوزن ينفصل خطياً كخاصية سطحية، من غير حاجة للعمق. نموذج 3B يطلع هوية الوزن في فضاء فرعي قابل للوصول الخطي من أول طبقة.
CCA للتشابه الذاتي يبدأ عند 0.889 في الطبقة 0 (أقل شوي من 0.921 في 1B)، لكنه يستقر أسرع: 0.977 عند الطبقة 1، و 0.995 عند الطبقة 3. خريطة الحرارة شبه موحدة وفاتحة من الطبقة 4 وطالع. RSA يطلع انتقالات ناعمة ومستمرة، من غير الكسر الحاد اللي ظهر في 1B عند الطبقات 3-4.
root-pattern CCA منخفض مرة في التشغيل المصحح: 0.02-0.07 عبر الطبقات كلها، والحد الأدنى 0.021 عند الطبقة 1. فضاءات أوزان الـ probe للجذر والوزن شكلها شبه متعامد تحت CCA في كل طبقة.
3B لسه عنده أوضح هبوط للجذر. بعد تصحيح التقسيم، 1B ما عاد يطلع منحنى اكتساب للوزن.
الاثنين 1B و 3B عندهم هوية الوزن تقريباً من الطبقة 0. نتيجة 3B المهمة هي هبوط الجذر: الهوية لسه قابلة للاسترجاع، لكنها أقل قابلية للوصول الخطي في وسط الشبكة.
ومع ذلك النموذج ما عنده مخرج عربي.
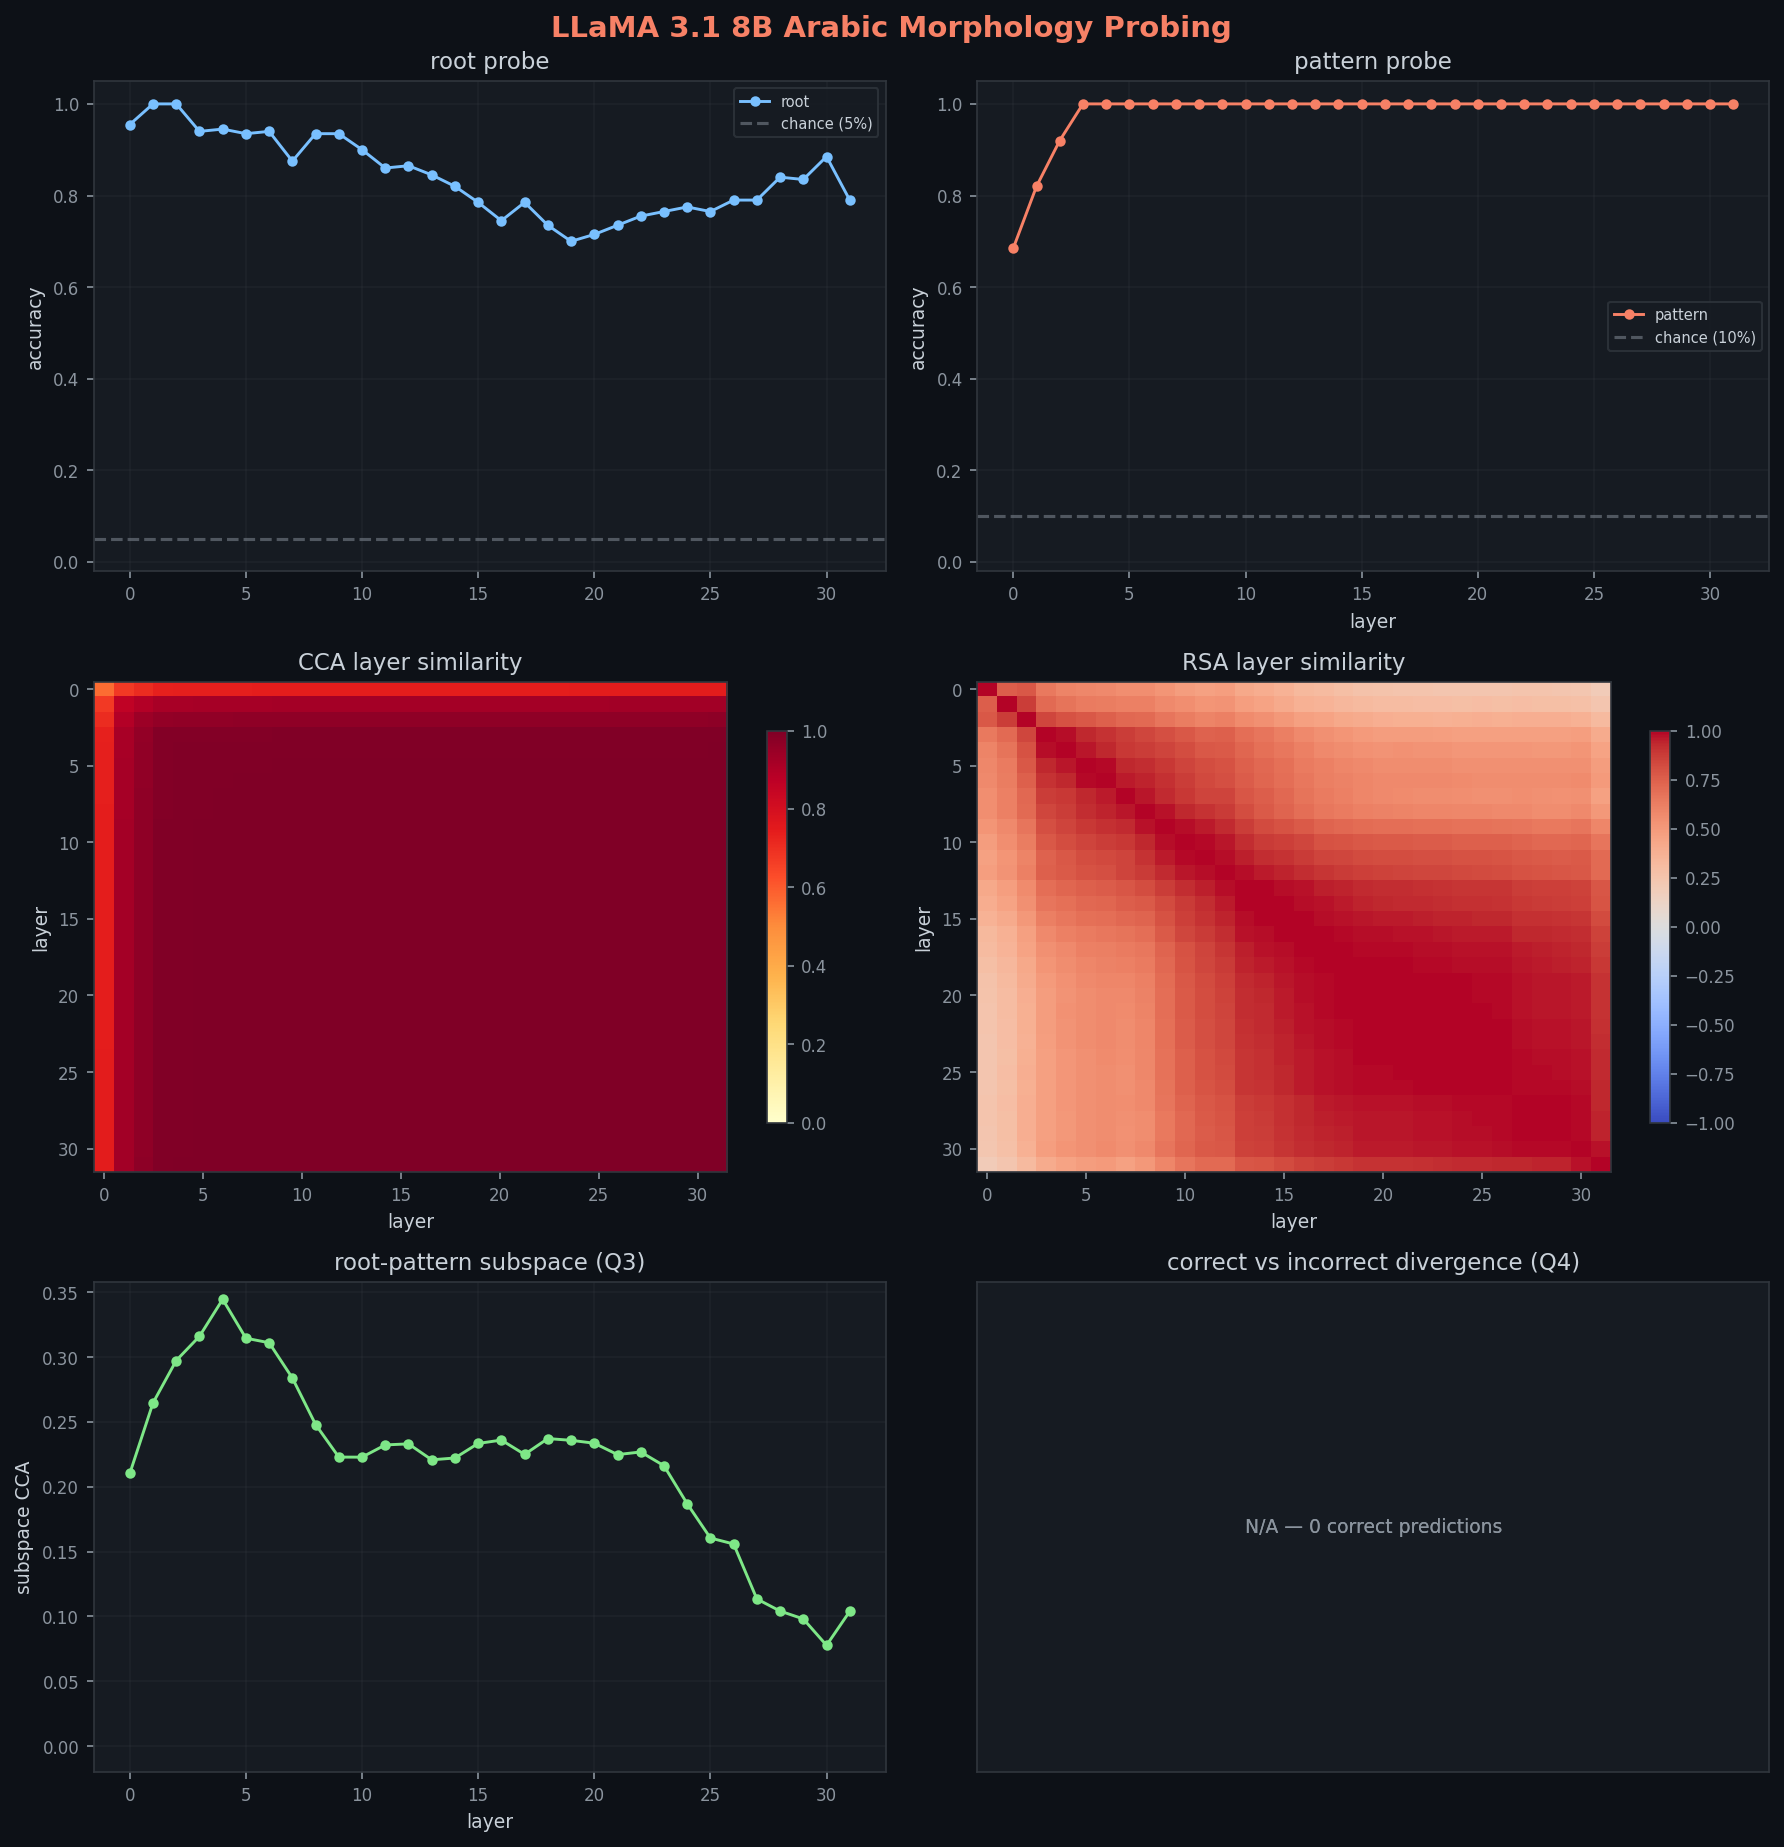
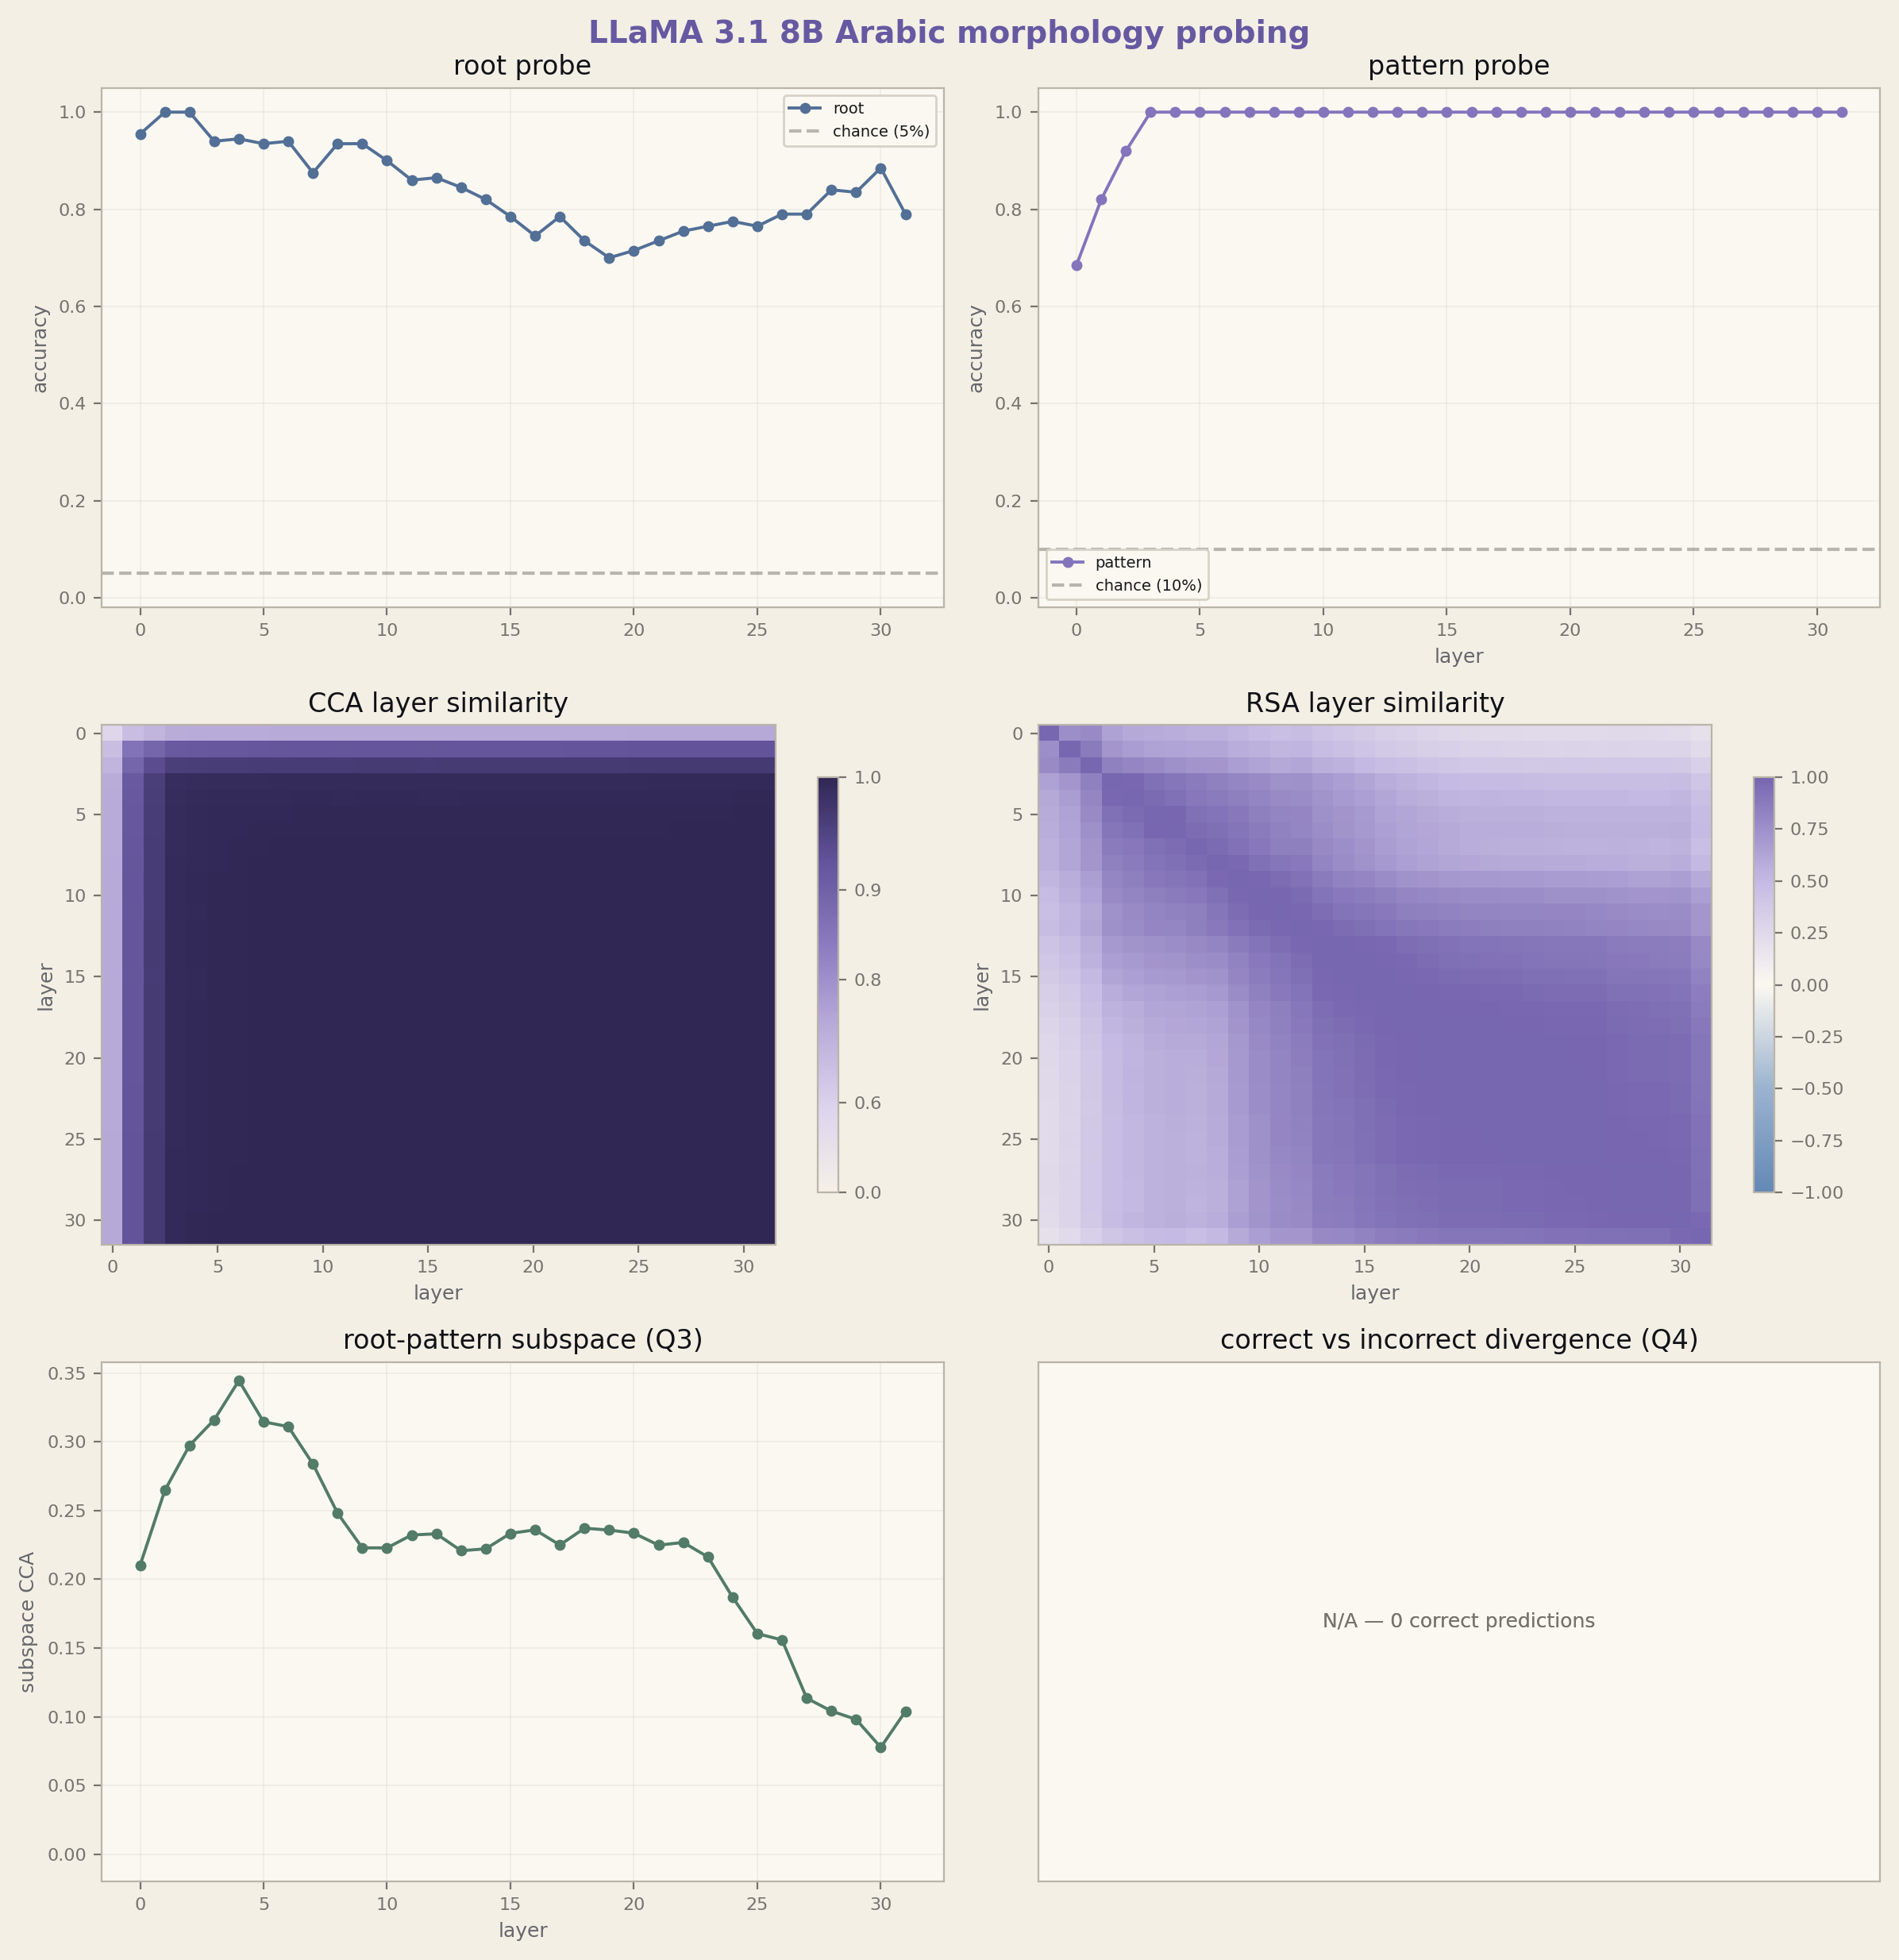
تنبيه أرشيفي: القسم هذا يستخدم ملفات التشغيل الأول لـ 8B، وما أعدناه بمنطق التقسيم المصحح. لا تقارن أرقامه الدقيقة مباشرة بنتائج 1B/3B المصححة.
هوية الجذر بدت كأنها تعمّق هبوط الـ U: بعد قمة قصيرة عند 100% (الطبقة 1)، تنزل عبر 94% ← 88% ← 75% ← وتوصل القاع عند 70% في الطبقة 19، ثم تتعافى جزئياً إلى 89%، وبعدها تنزل مرة ثانية إلى 79% في الطبقة الأخيرة.
المنحنى مليان تفاصيل، ومو U نظيف: نزول متعرج مع هبوط ثانوي في النهاية. اعتبره إشارة مؤرشفة، مو استنتاج تحجيم مصحح.
هوية الوزن بدت كسلم في التشغيل المؤرشف: 69% في الطبقة 0 ← 82% ← 92% ← 100% عند الطبقة 3. وبما إن نتيجة 1B تغيّرت بعد التصحيح، فالادعاء هذا عن 8B ينتظر إعادة التشغيل.
CCA يبدأ منخفض مرة: 0.566 عند الطبقة 0، وهذا أكثر تمثيل مبكر مشوش بين النماذج. بعدها يصعد: 0.68 (الطبقة 1) ← 0.94 (الطبقة 2) ← 0.99 (الطبقة 4).
خريطة الحرارة فيها زاوية سفلية يسارية غامقة بوضوح، وتنفتح خلال أول 4 طبقات. RSA ارتباط الطبقة 0→1 هو 0.76، وبعدها يصير ناعماً بين 0.96 و 0.999.
root-pattern CCA يطلع أهم منحنى: يرتفع إلى قمة 0.345 عند الطبقة 4، يعني فضاءات الـ probe تتداخل أكثر مؤقتاً، وبعدها ينزل بثبات إلى 0.078 عند الطبقة 30. هذا ينسجم مع خلط تمثيلي بدري ثم فصل لاحق: الطبقات الأولى فيها تداخل أكبر بين فضاءات أوزان probe للجذر والوزن، والطبقات الأعمق تنظيمها أكثر انفصالاً.
لا 1B (انخفاض رتيب) ولا 3B (شبه مسطح قرب الصفر) يطلع عنده هذا النمط ثنائي المرحلة.
فحص الجذر غير رتيب في التشغيلين المحليين المصححين. 1B يظل عالياً وشبه مسطح؛ 3B يطلع عنده هبوط في الوسط بقاع 86%. التشغيل القديم لـ 8B اقترح قاعاً أعمق عند 70%، بس ينتظر إعادة التشغيل بالتقسيم المصحح.
التشغيل المصحح لـ 1B/3B: 0/200 صحيحة. متغيرات الـ prompt نقدر نسترجعها؛ والسلوك لسه مكسور.
هذا هو اللغز الأساسي. التشغيلان المصححان لـ 1B و 3B عندهم متغيرات جذر ووزن قابلة للفك الخطي.
هوية الجذر عالية، لكنها تنزل في وسط 3B؛ وهوية الوزن شبه كاملة من الطبقة الأولى. المعلومة نقدر نسترجعها وهي مرتبة، بس نقطة الاستخراج الحالية هي آخر توكن في prompt اللي يذكر الجذر والوزن صراحة.
مع ذلك، كل نموذج يرجع نفس المخرج الموحد لكل محفز: The. نقدر نسترجع متغيرات الجذر والوزن من الـ hidden states، لكنها ما تتحول إلى output tokens المطلوبة في الإعداد هذا.
متغيرات الـprompt المكتوبة نقدر نسترجعها في الإعداد هذا. بس لسه ما فصلنا بين حساب صرفي واحتفاظ بنص التعليمات. نتيجة GPT-4o المنشورة، 97%، نتيجة سلوكية منفصلة؛ ما تعزل الـinstruction tuning كسبب لفشل المخرج هنا.
ورقة Alakeel خلصت إلى أن "الاستدلال التركيبي + اتباع التعليمات يعوض التحليل الصرفي الصريح." نتائجنا تمشي مع صياغة أدق: اتباع التعليمات ممكن يكون اللي يربط متغيرات المهمة القابلة للاسترجاع بسلوك المخرج. عشان نخلي الدعوى الصرفية أقوى، نحتاج prompt ablations، واستخراجاً من مواضع الجذر والوزن، وتجارب نحذف أو نستبدل فيها نص الجذر أو الوزن.
"الأكبر أفضل" ما يصف فحص الجذر هنا. منحنى الدقة المصحح محلياً ينتقل من شبه مسطح (1B) إلى شكل U (3B). التشغيل القديم لـ 8B ممكن يعمّق النمط، بس مو داخل المقارنة المصححة إلى الآن. وهذا ينسجم مع فرضية الخطة البحثية الأصلية:
الخطة الأصلية اقترحت إن الفرق بين 1B و3B ممكن يحدد حجم يفيد عنده إدخال الصرف صراحة. التشغيل هذا ما يختبر التدخل، وكشف الـlabels في الـprompt يمنعنا نفسر المنحنيات كدليل على حد للحجم.
تشغيلتا 1B و3B المصححتان تختلف في استرجاع الجذر المكتوب عبر الطبقات. هذا فرق وصفي تحت الـprobe والـprompt المستخدمين هنا. ما يثبت انتقال نوعي في حساب الصرف، ولا إن المعلومة ضاعت ورجعت داخل الشبكة.
النتيجة المصححة أبسط وأكثر تحفظاً: الوزن ينفصل خطياً من أول طبقة تقريباً في 1B و 3B. هذا منطقي لأن الـ prompt يذكر اسم الوزن صراحة. النتيجة مفيدة، بس ما تثبت لحالها إن النموذج نفّذ تركيباً صرفياً عربياً.
فيه كم تفسير ممكن:
منحنى root-pattern CCA في 8B (يصعد إلى 0.345 عند الطبقة 4 ثم ينزل إلى 0.078) يطلع بنمط ينسجم مع تنظيم على مرحلتين: الطبقات المبكرة فيها تداخل أعلى بين فضاءات أوزان probe للجذر والوزن، والطبقات الأعمق فيها فضاءات أكثر انفصالاً. شكل القمة ثم الهبوط مو موجود عند الحجمين الأصغر.
حتى لو الشكل هذا صمد بعد إعادة 8B وتكرر في Qwen أو Mistral، كشف الـlabels يخليه نتيجة عن الاحتفاظ بمعلومات الـprompt. ادعاء عن التركيب الصرفي يحتاج مدخلات surface-only ودليل سلوكي أو تدخل مستقل.
كل البيانات المصححة لسه تستخدم English zero-shot prompts وآخر توكن في الـ prompt. المخرج الموحد The ممكن يكون أثر chat-template؛ اختبار Arabic prompts و one-shot و prompt ablations ممكن يغيّر القصة.
200 محفز لتصنيف من 20 فئة = 10 عينات لكل فئة قبل cross-validation. منطق التقسيم المصحح يتفادى الطيات المستحيلة، بس لسه نحتاج محفزات أكثر وفواصل ثقة.
--probe-template، واستخراجاً من موضع الجذر والوزن، وتجارب نحجب فيها الجذر أو الوزن. هذا العائق الأساسي قبل ما نقدر نطرح دعوى صرفية أقوى.