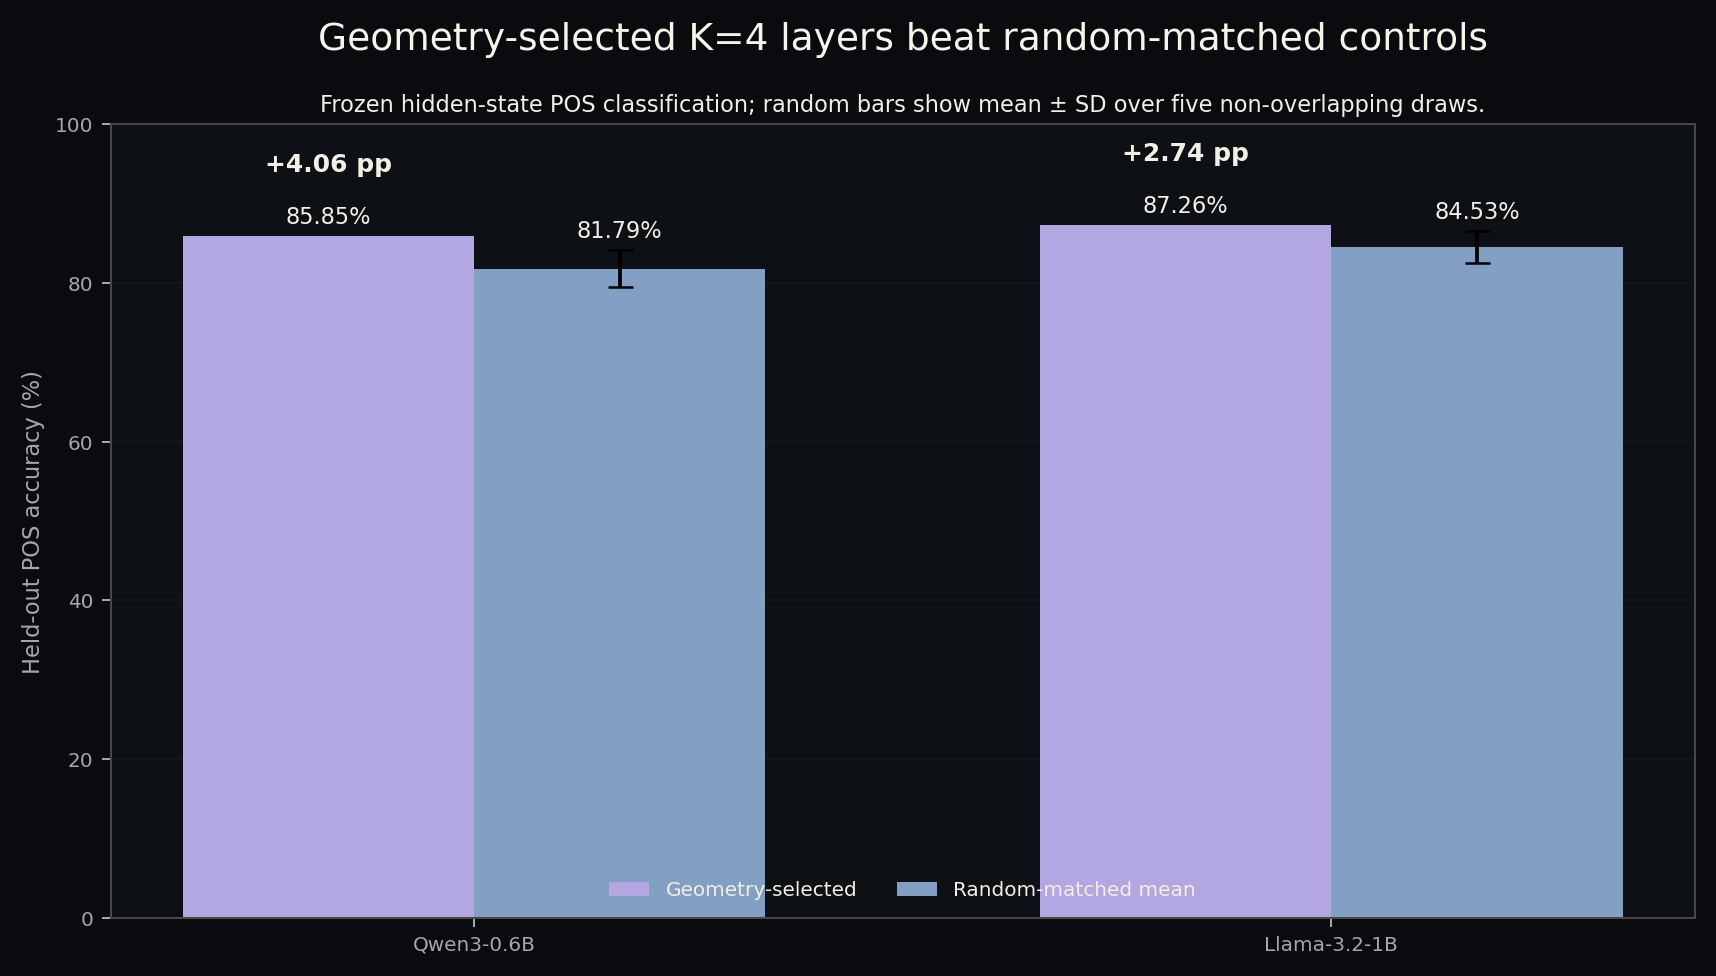
مجموعات الطبقات المختارة على development حملت إشارة POS أقوى على الاختبار المحجوز من الضوابط العشوائية. عند K=4، تحسن macro-F1 بـ4.70 نقطة في Qwen و3.15 في Llama، وفازت على المجموعات العشوائية الخمس في كل نموذج. الاختبار على features ثابتة؛ تكييف LoRA لسه ما اختبرناه.
درّبنا مصنفات خطية ثابتة على hidden states مجمّدة ومضمومة من Qwen3-0.6B وLlama-3.2-1B. تكرار نتيجة K=4 يبرر تجربة targeted LoRA صغيرة. نجاح التكييف ومكان الصرف سببياً لسه أسئلة مفتوحة.
الدليل هنا كله من خصائص مجمّدة فقط. هذي مو نتيجة LoRA، ومو دليل على نجاح التكييف، ومو دليل على أن الصرف العربي متمركز سببياً في أربع طبقات.
الصرف العربي يطلع اختبار مفيد لأن بنيته غنية ولأن التعميم مهم. الصيغ قد تشترك في الجذر أو اللمّة أو النمط السطحي، وعشان كذا random split سهل ممكن يكافئ التداخل المعجمي بدل الإشارة الصرفية اللي نحاول نقيسها.
والتكييف على طبقات عشوائية مو baseline مفيد إذا ما كان مضبوطاً. تغيير عدد الطبقات أو الوحدات المستهدفة أو رتبة adapter أو البيانات أو ميزانية التدريب يغير السعة أو الحساب مع اختيار الطبقات.
المقارنة هنا أضيق بكثير: طبقات مختارة من الإشارة التمثيلية مقابل طبقات عشوائية غير متقاطعة، وكل شيء ثاني ثابت.
الضابط المحلي ما يقدر يضمن إن targeted LoRA راح ينجح. بس يقدر يقول إذا كان التدخل المقترح يحمل إشارة كافية تستحق تجربة تدريب حقيقية.
مسارات البيانات وSHA-256 checksums ومعرّفات التقسيم ومصدر الاختيار بقيت ثابتة. بيانات manifest المستقبلية لـLoRA تعلن أيضاً مجموعة q_proj/v_proj نفسها، والرتبة 8، وalpha بقيمة 16، وعدد معاملات adapter متساوياً داخل كل K.
هذي أسماء وحدات مستقبلية للمحافظة على تكافؤ الـmanifests. sklearn ما يلمس q_proj أو v_proj؛ هو يضم متجهات hidden states المجمّدة للطبقات المختارة ويدرّب مصنفاً خطياً. هذا اختبار لإشارة مجموعة الطبقات، مو حقن adapters.
| النموذج | K | دقة geometry-selected | متوسط العشوائي ± الانحراف | الفرق | مرات الفوز | المئين |
|---|---|---|---|---|---|---|
| Qwen3-0.6B | 1 | 83.49% | 84.91% ± 1.16 | −1.42 pp | 1/5 | 20th |
| Qwen3-0.6B | 2 | 83.96% | 82.83% ± 2.61 | +1.13 pp | 4/5 | 80th |
| Qwen3-0.6B | 4 | 85.85% | 81.79% ± 2.32 | +4.06 pp | 5/5 | 100th |
| Llama-3.2-1B | 1 | 87.74% | 85.09% ± 2.10 | +2.64 pp | 5/5 | 100th |
| Llama-3.2-1B | 2 | 85.38% | 85.28% ± 2.22 | +0.09 pp | 3/5 | 60th |
| Llama-3.2-1B | 4 | 87.26% | 84.53% ± 2.03 | +2.74 pp | 5/5 | 100th |
نتيجة K=4 موجبة في النموذجين، وفازت على الضوابط العشوائية الخمسة كلها في كليهما. تحسن macro-F1 بمقدار 4.70 نقطة في Qwen و3.15 نقطة في Llama.
نتائج K=1 وK=2 مهمة أيضاً: Qwen عند K=1 ما تفوق على الضابط العشوائي، وLlama K=2 شبه محايد. النتيجة مو «الطبقات المختارة تفوز دائماً»؛ هي إشارة محلية متكررة عند K=4.
الجدول يعرض نتيجة الاختيار الهندسي ناقص متوسط الضوابط العشوائية على اختبار held-out.
| النموذج | الفئة | فرق precision | فرق recall | فرق F1 |
|---|---|---|---|---|
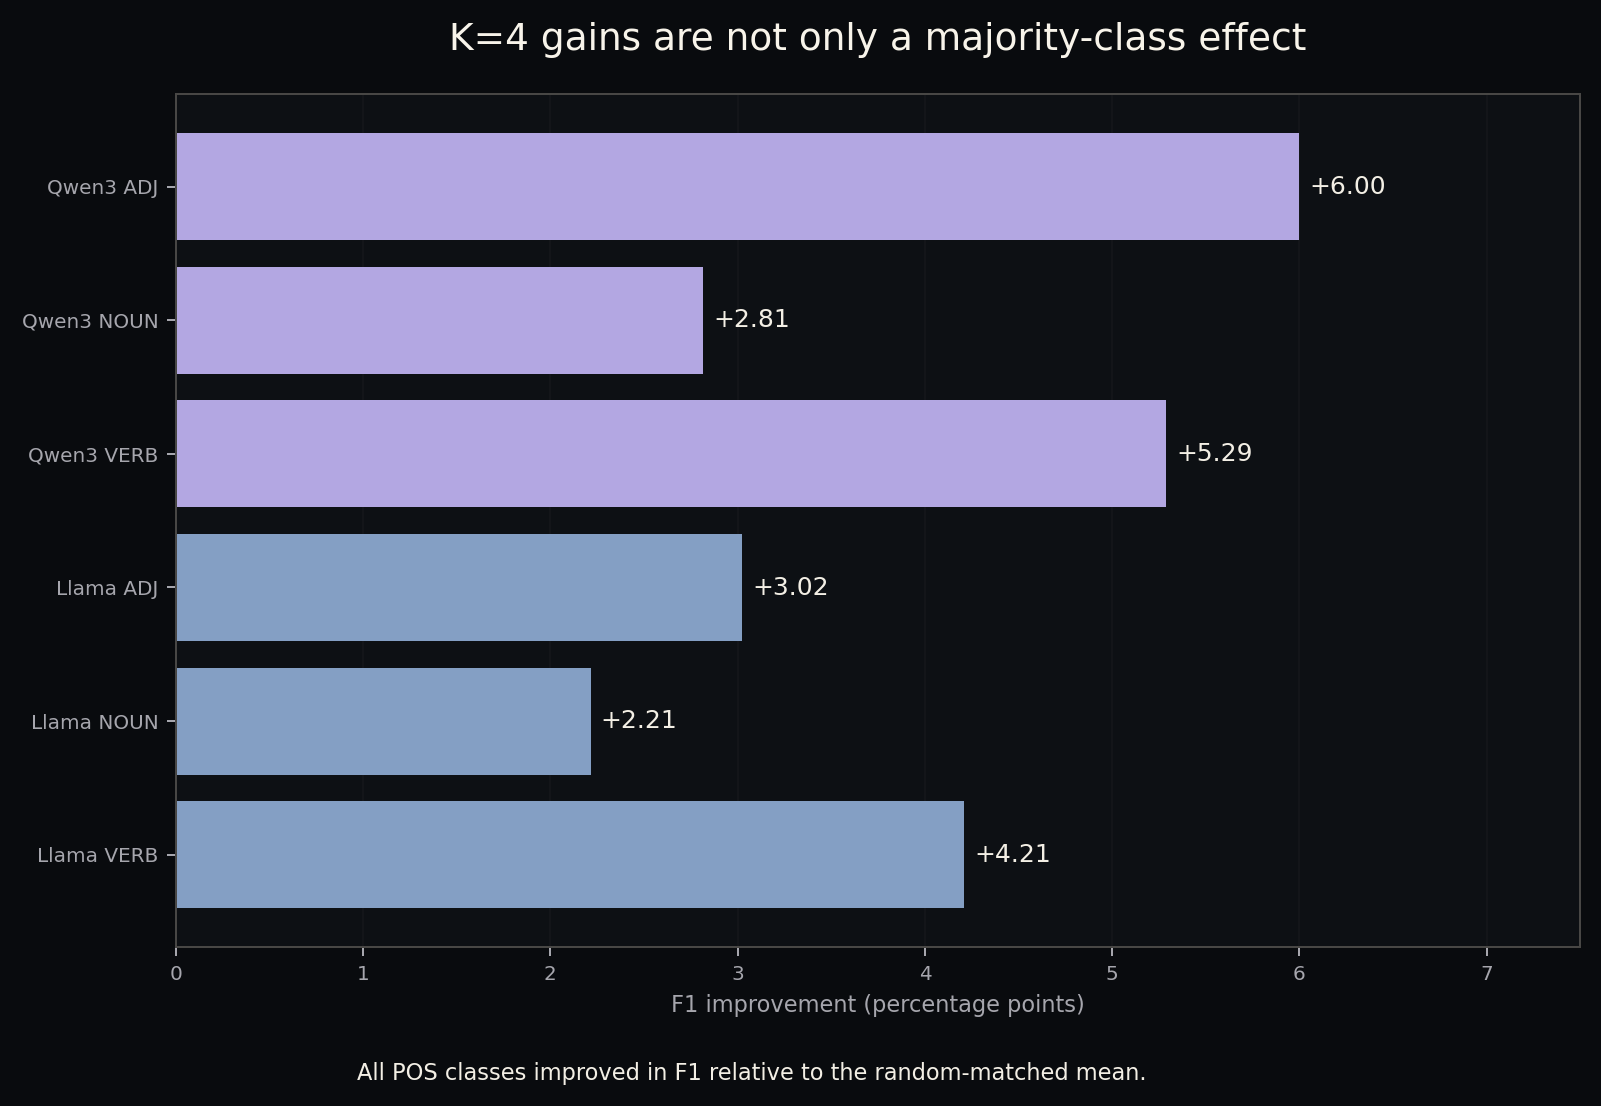
| Qwen | ADJ | +8.17 pp | +3.81 pp | +6.00 pp |
| Qwen | NOUN | −0.19 pp | +5.37 pp | +2.81 pp |
| Qwen | VERB | +8.71 pp | −0.56 pp | +5.29 pp |
| Llama | ADJ | +0.57 pp | +5.71 pp | +3.02 pp |
| Llama | NOUN | +1.76 pp | +2.54 pp | +2.21 pp |
| Llama | VERB | +6.37 pp | 0.00 pp | +4.21 pp |
التدخل الأول مجمّد مسبقاً: Qwen3-0.6B، ومهمة
POS، وK=4، والطبقات المختارة
7, 8, 18, 20، وخمسة ضوابط عشوائية ثابتة
وغير متقاطعة. كل تشغيل يستهدف q_proj/v_proj برتبة 8
وalpha بقيمة 16، وبالضبط 163,840 معامل
adapter قابل للتدريب. الميزانية 200 خطوة
optimizer.
المقياس الأساسي هو held-out POS macro-F1. النجاح يعني أن شرط الاختيار الهندسي يتجاوز المتوسط الحسابي للضوابط العشوائية الخمسة ويفوز بصرامة على ثلاثة منها على الأقل. الدقة وF1 لكل فئة تشخيصات ثانوية.
قبل ما نبدأ، لازم تتجمّد نسخة النموذج والـtokenizer، والـbackend، وأقصى طول للسياق، وحجم الدفعة وتجميع التدرجات، ومعدل التعلم، والـoptimizer، والـscheduler، والـwarmup، والـweight decay، والـdropout، والدقة العددية، ودورية التقييم، وسياسة حفظ الـcheckpoints. ما فيه early stopping في التجربة الأولية.
في النموذجين الصغيرين، مجموعات K=4 المختارة على development حملت إشارة POS أقوى من المجموعات العشوائية الخمس، والتحسن ظهر في فئات POS الثلاث. هذا يبرر اختبار التدخل التالي؛ نجاح التكييف نفسه لسه ما انقاس هنا.