الـprobes المؤرشفة قرأت الجذر والوزن المكتوبين أصلاً في الـprompts. عبر سبعة نماذج، دقة الوزن وصلت 1.000 في القمة وفي الطبقة الأخيرة. هذي ضوابط لاسترجاع معلومات الـprompt؛ الإعداد ما يثبت استنتاج الصرف من الكلمة وحدها.
هذا تشغيل أولي مؤرشف على محفزات nonce root-pattern. السؤال اللي يقدر يجاوبه: هل الـprobe يسترجع الجذر والوزن المكتوبين في الـprompt من الـhidden states المحفوظة؟
النتائج وصفية بس. الـ probes تقيس قد إيش نقدر نسترجع المعلومة من التمثيلات الداخلية، وما تثبت إن النموذج فاهم الصرف العربي أو يستخدم المعلومة هذي سببياً في التوليد.
نتائج الوزن مشبعة في الإعداد هذا، فما تنفع لمقارنات العائلات أو الأحجام. ونتائج Gemma E2B في الطبقات المتأخرة تحتاج حذر زيادة، لأن تحقق golden-logit وصل بس إلى cosine ~0.87 مقابل llama.cpp.
سحبت التمثيلات باستخدام ember
عبر --probe على stimuli/nonce_root_pattern.json.
البيانات فيها 20 جذر افتراضي و10 أوزان، يعني 200 محفز. الصفحة هذي
تستخدم ملفات التشغيل المحفوظة في
artifacts/morphology_runs/20260613_022050.
pattern-heldout.root-heldout.
ملفات الـ NPZ فيها كمان split_policy=random.
في الملاحظة هذي، نعتمد حقول كل مهمة كمرجع، ونتعامل مع الحقل العام
كأثر تسجيل، مو كسياسة التقسيم الفعلية.
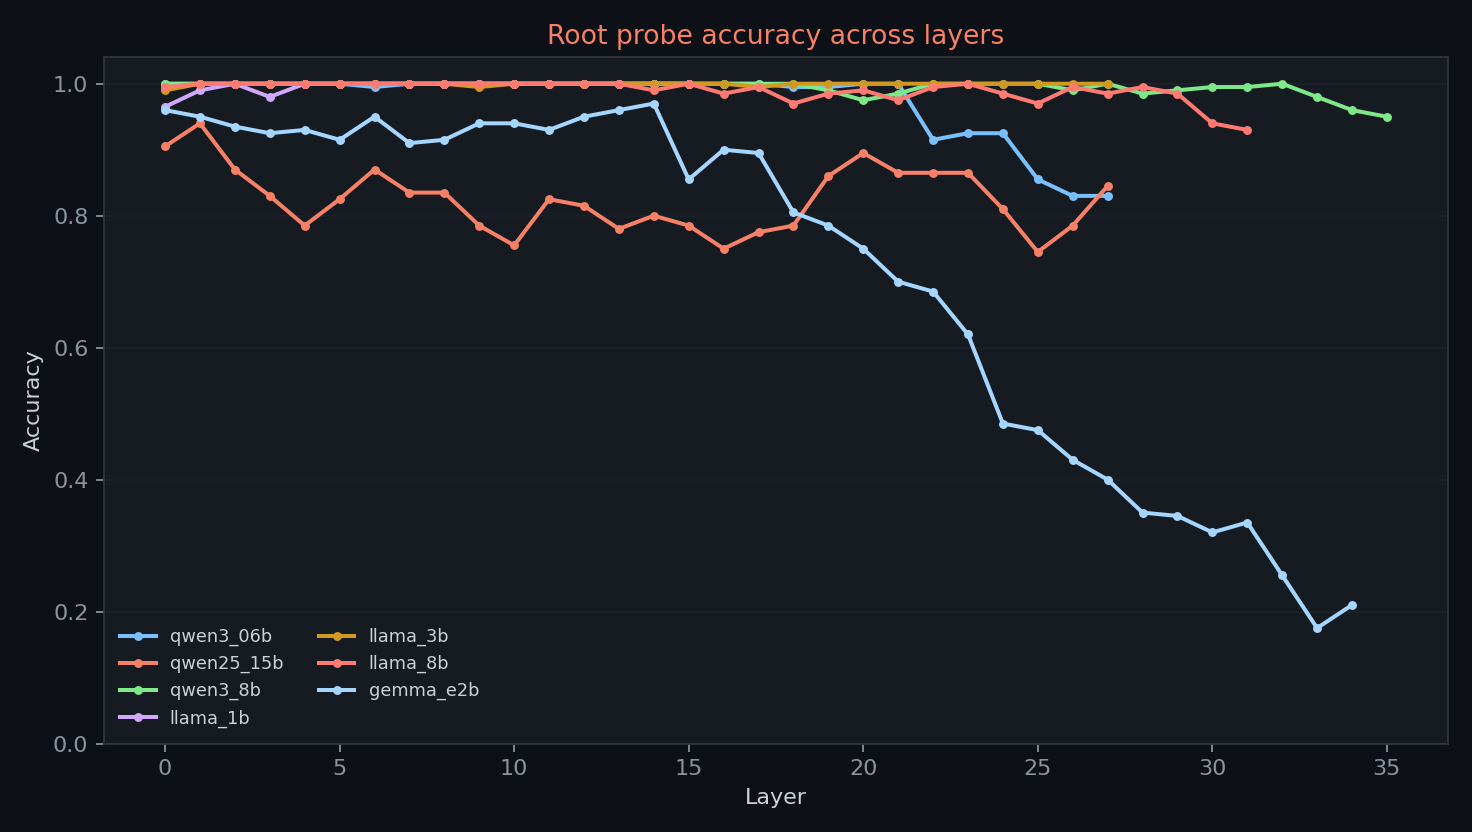
الجذر هو المهمة الأكثر فائدة هنا، لأنه يختلف بين النماذج والطبقات. خمسة نماذج توصل لقمة 1.000، بينما Qwen 1.5B يوصل إلى 0.940 وGemma E2B إلى 0.970.
في مهمة الجذر، الهبوط في الطبقة الأخيرة واضح: كل نماذج Qwen تنزل عن القمة، وLLaMA 8B ينزل، وGemma E2B عنده أكبر هبوط. بالمقابل، LLaMA 1B وLLaMA 3B يظلان مشبعين في الطبقة الأخيرة.
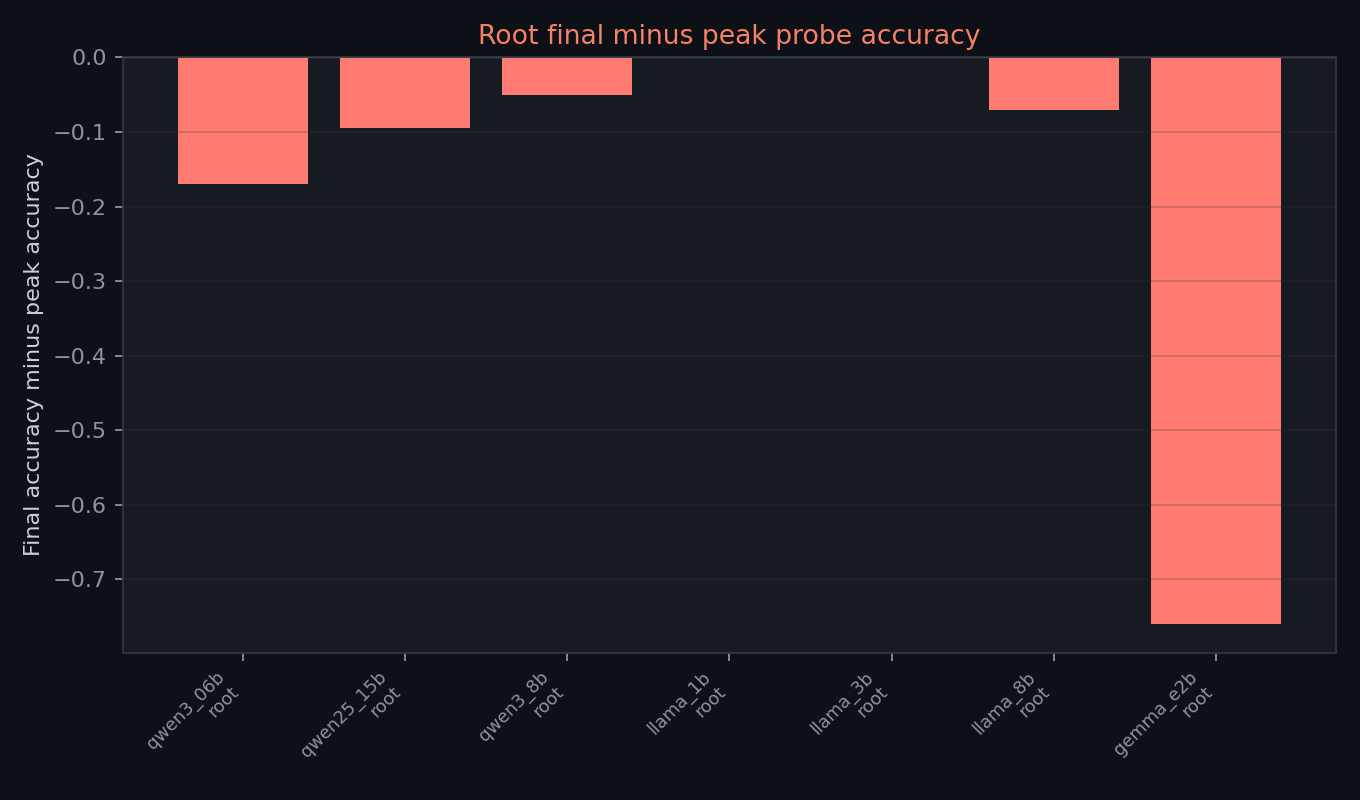
الفرق بين LLaMA وQwen في الطبقة الأخيرة ظاهر في الجدول، بس تحت prompts تكشف الـlabels. نحتفظ به كوصف للتشغيل، مو كفرق مثبت في الصرف أو سبب عائلي.
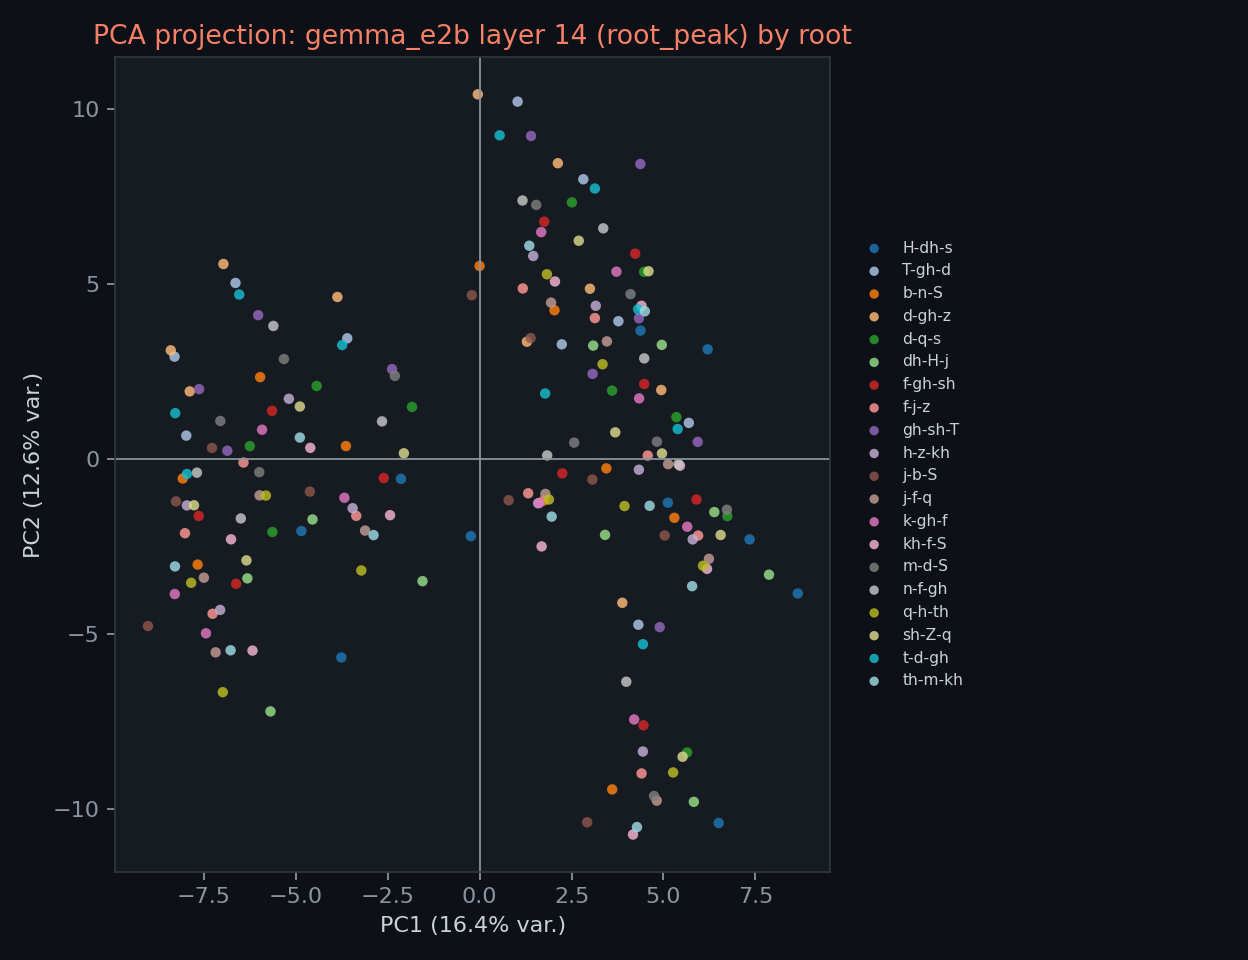
Gemma E2B يوصل قمة الجذر في الطبقة 14، وبعدها ينزل من 0.970 إلى 0.210 في الطبقة الأخيرة. المنحنى واضح بالعين، بس مو دليل نظيف على تمثيل صرفي خاص بـ Gemma.
تحقق golden-logit وصل إلى cosine ~0.87 مقابل llama.cpp، وفيه انجراف تدريجي من الطبقة 5 وما بعدها. عشان كذا، ممكن التمثيلات المتأخرة متأثرة بتراكم عددي في التنفيذ، مو بس ببنية صرفية داخلية.
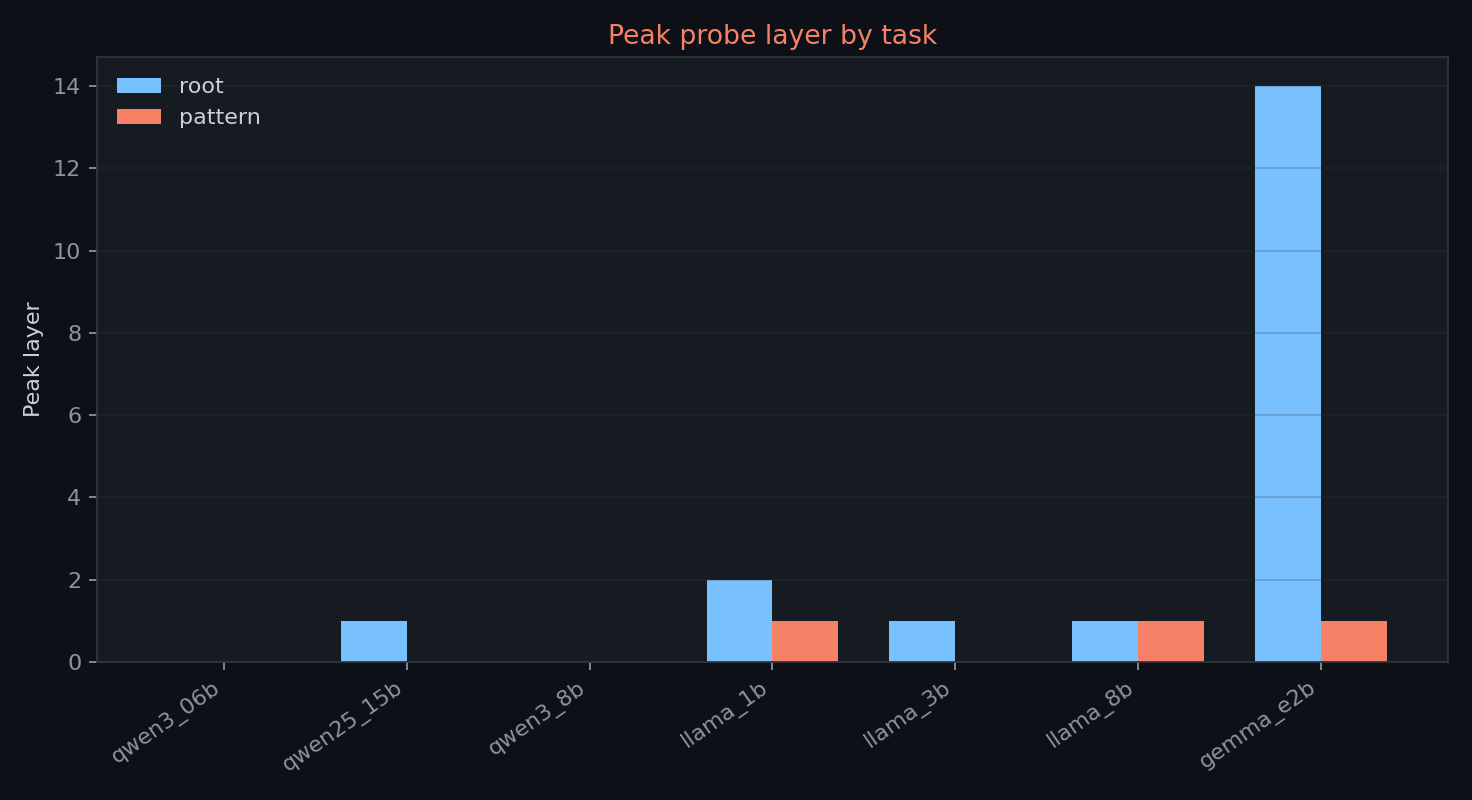
الوزن يوصل 1.000 في القمة وفي الطبقة الأخيرة عند كل النماذج السبعة. هذا يحد التفسير: المهمة فيها 10 فئات بس، وممكن المحفزات سهلة مرة على الإعداد هذا. عشان كذا ما أستخدم نتائج الوزن لدعم مقارنات عائلية أو مقارنات حجم في التشغيل هذا.
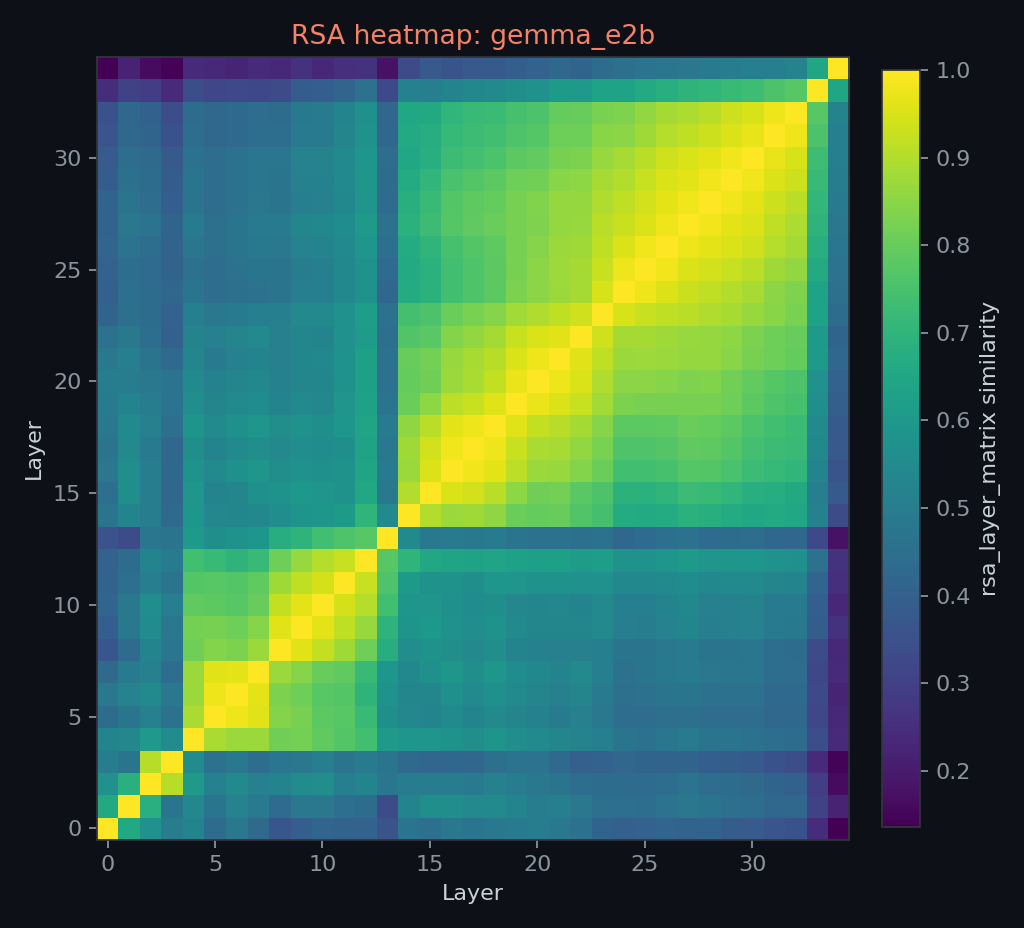
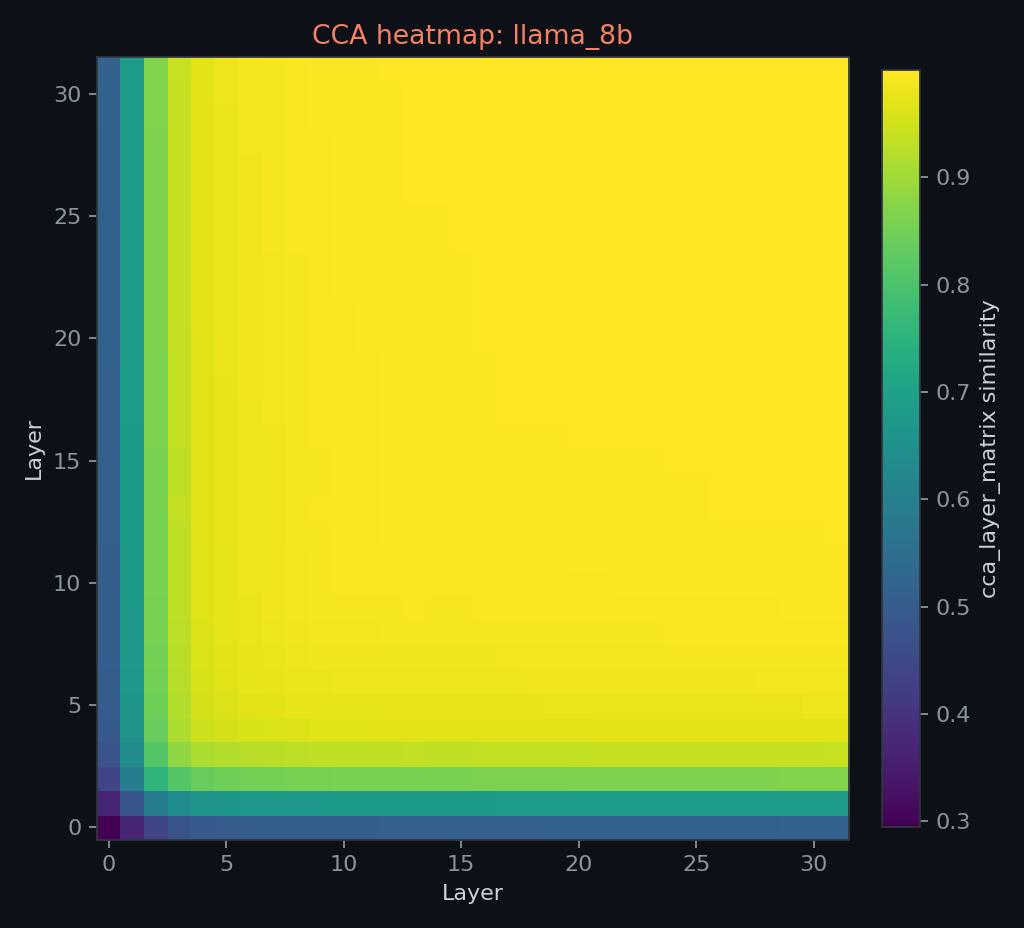
رسوم RSA وCCA وPCA هنا استكشافية بس. الملفات الحالية داخل كل نموذج، مو مقارنات هندسية مباشرة بين النماذج.