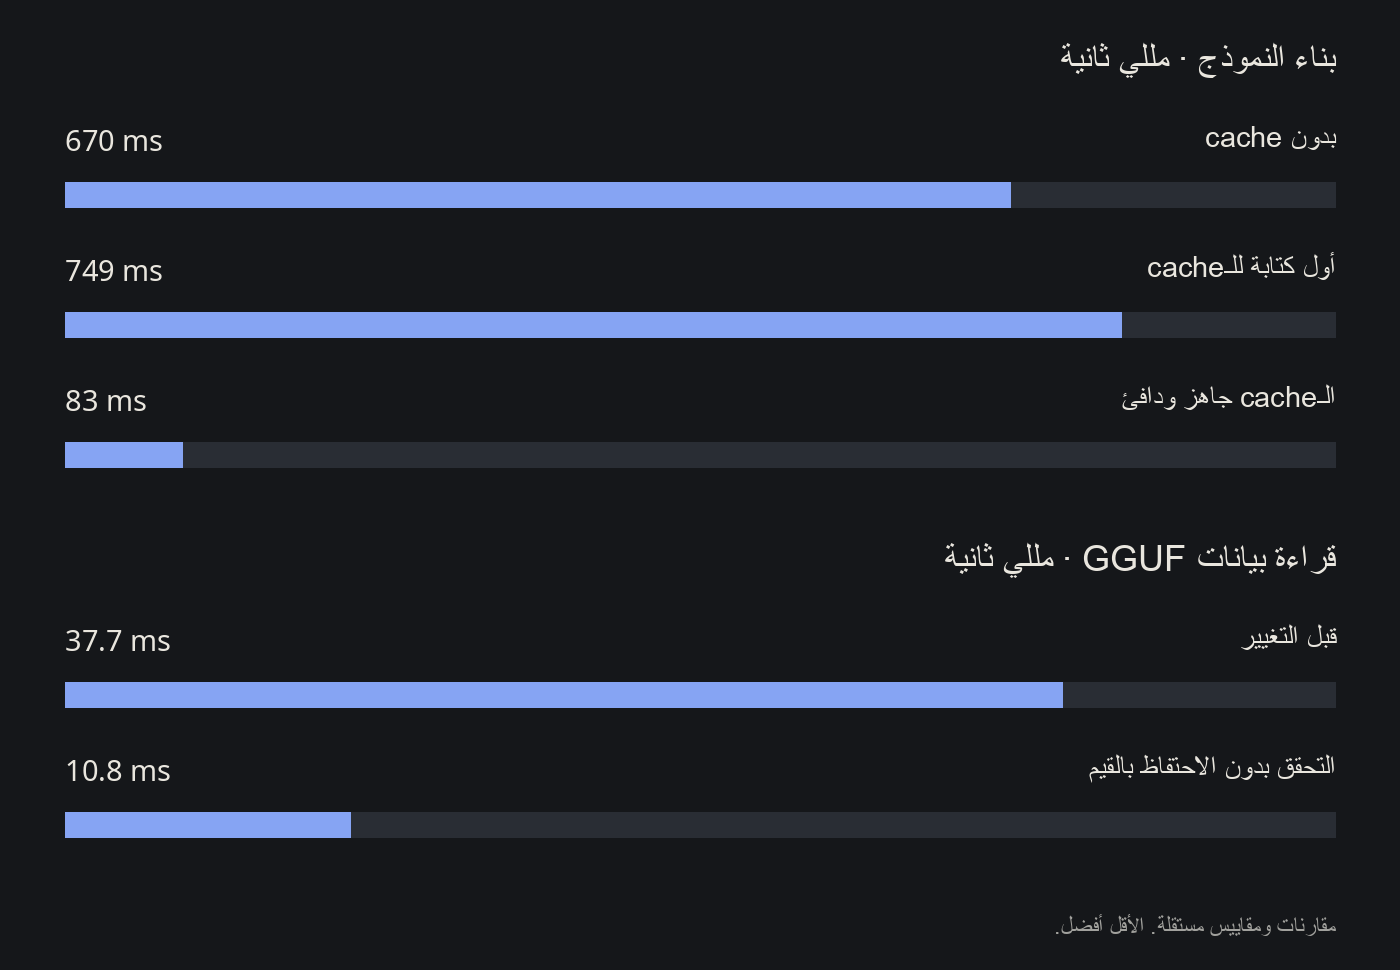
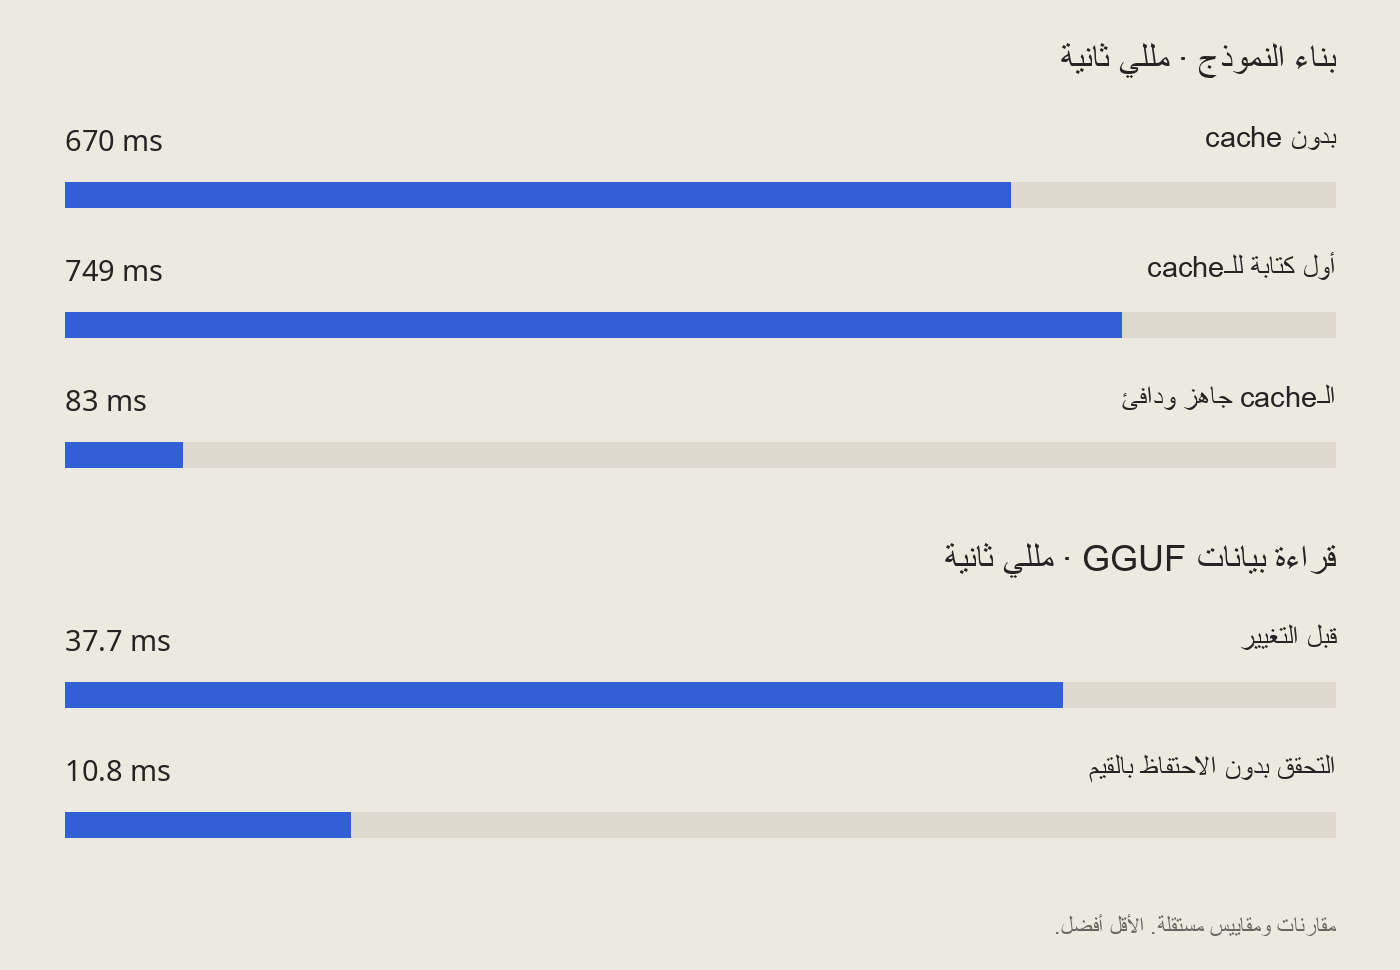
الـcache الجاهز قلّل وقت بناء Llama-3.2-1B Q8_0 في Ember. الوقت نزل من 670 إلى 83–84 مللي ثانية. سرعة الـdecode بقيت داخل ضوضاء القياس؛ المكسب هنا في البناء الدافئ.
وفيه شغل ثاني قلّل وقت قراءة بيانات GGUF الوصفية وعدد تخصيصات الذاكرة لكل توكن. الأرقام هنا من تقرير المرحلة الثالثة، مع إضافات 12 سبتمبر. كل مقارنة هنا تقيس جزء مختلف، فما ينفع نضرب نسب التحسن في بعض ونطلع منها بنسبة للتشغيل كامل.
القياسات على Intel Core i5-1135G7 بنظام Arch Linux، مع أربعة threads من Rayon، مثبتة على CPUs 0–3. التقرير يسجل الـwarmups وتكرار القياسات والتبديل بين النسختين أثناء المقارنة.
الجهاز كان يخفّض تردده بسبب الحرارة، أو thermal throttling. عشان كذا، أي فرق داخل نطاق ضوضاء القياس، حوالي 3%، ما حسبته تحسناً في سرعة الـdecode.
أمر bench-decode يقيس الـdecode لحاله، بدون ما يدخل معاه وقت التحميل والـprefill. تقرير التحميل صار يفصل ربط الملف بالذاكرة، وقراءة الـmetadata، وقراءة جدول الـtensors، وتجهيزها، وبناء النموذج. كمان يسجل وقت الـpacking وقد إيش من البيانات مقيم في الذاكرة. وللـprefill وأول توكن قياسات لحالها.
يعني مرحلة بناء النموذج صارت أسرع بحوالي ثمانية أضعاف لما الـcache جاهز ودافئ. الرقم هذا ما يقيس الانتظار كامل لأول توكن، ولا الـcold start، ولا سرعة إنتاج التوكنات.
الشكل 1. الأقل أفضل، وكل رسم له مقياس مستقل بالمللي ثانية.
أرقام بناء النموذج من قياسات 12 سبتمبر: الوسيط بدون cache هو 670؛ تشغيلات الكتابة الأولى 746/749/751؛ وتشغيلات الـwarm hit هي 83/84/83. أرقام الـmetadata من مقارنة ثانية بخمسة تشغيلات متداخلة.
هذي قياسات منفصلة، مو أجزاء من نفس التشغيلة.
أوزان Q8_0 تجي بترتيب صفوف متجاورة. نوى الـdecode في Ember تستخدم packed layouts، فبناء النموذج يشمل إعادة ترتيب الأوزان عشان تناسبها.
في قياس سابق، من أصل 663 مللي ثانية لبناء النموذج، 478 راحت على VNNI packing و99 مللي ثانية على ترتيب الـoutput head المتداخل. القياس هذا ووسيط الـ670 مللي ثانية بدون cache اللي تحت من جولتين مختلفتين؛ تفصيل الـpacking هنا مو تفصيل للـ670.
وهذا الشغل كان يتكرر كل ما تبدأ process جديدة. الـcache الدائم يحفظ الترتيبين، وبعد ما يتأكد إن النسخة المحفوظة صالحة، يربط نطاقات البايتات بالذاكرة مباشرة. صار شغال افتراضياً في التوليد العادي وقياس الـdecode؛ ولو تبغى المسار بدون cache تستخدم EMBER_PACKED_CACHE=0.
| إعداد Llama-3.2-1B Q8_0 | وقت بناء النموذج | إيش يصير في الـcache؟ |
|---|---|---|
| بدون cache | الوسيط 670 مللي ثانية | ترتيب الأوزان في الذاكرة |
| أول تشغيل | 746–751 مللي ثانية | كتابة 1.31 GiB؛ 113 misses |
| Warm hit | 83–84 مللي ثانية | ربط الترتيبات المحفوظة؛ 113 hits |
طبعاً أول كتابة تاخذ وقت ومساحة على القرص. على قرص NVMe في هذا الجهاز، لما باعدت بين التشغيلات، الكتابة أضافت حوالي 80 مللي ثانية فوق وقت البناء بدون cache.
بس لما شغلت كتابات جديدة ورا بعض، والـwriteback كان لسه يصرف البيانات المتراكمة من الذاكرة للقرص، وصلت أزمنة التشغيل إلى 5–20 ثانية. يعني كلفة أول تشغيل تعتمد على وضع الـI/O وقتها.
الـcache يتحقق من الهوية والـlayout والحدود وأطوال الإدخالات. يكتب في ملف مؤقت، وبعد ما يخلص ينشره بإعادة التسمية.
لو فشل يرجع يرتب الأوزان في الذاكرة. الاختبارات تغطي تطابق البايتات، وإبطال الإدخالات، والملفات التالفة أو المقطوعة، والكتابة المتزامنة.
وفي التشغيل الحتمي المقاس، خرج Llama طلع مطابق بين المسار العام، والـpacked، والـcached.
الحد الافتراضي لحجم مجلد الـcache هو 8 GiB، وتقدر تغيره من EMBER_PACKED_CACHE_BYTES. بعد ما يحفظ ملف جديد بنجاح، ينظف المجلد ويبدأ بالملفات اللي مرّ أطول وقت من آخر استخدام لها.
بس أحدث ملف يبقى، حتى لو لحاله أكبر من الحد. يعني هذا هدف للتنظيف، مو سقف صارم لاستخدام القرص.
والتنظيف يصير بعد حفظ الملف، فالكتابة نفسها ممكن تتجاوز الهدف مؤقتاً كمان. وما فيه فحص مسبق للمساحة الفاضية؛ لو الكتابة فشلت، يرجع للـpacking العادي.
Gemma 4 E2B يوضح ليش النسبة تختلف من نموذج لنموذج. بعد إصلاح حدود الـloader وفحوص أشكال الـtensors، تخزين ترتيبات gate/up نزل وقت البناء من 2.06–2.28 ثانية إلى 1.54–1.60 ثانية.
إعادة الـpacking تاخذ حصة أصغر من وقت بناء Gemma، فعشان كذا تجاوزها وفّر تقريباً ربع الوقت. نفس الفكرة، بس حجم المكسب يعتمد على فين يروح وقت النموذج أصلاً.
في Llama-1B Q8_0، وقت قراءة الـmetadata نزل من 37.7 إلى 10.8 مللي ثانية. وفي نفس المقارنة، وقت تشغيل الأمر كامل في الحالة الدافئة نزل من 295 إلى 210 مللي ثانية. باقي لازم يمر على طول كل نص لحاله، وهذا له كلفة.
بعد ما صرنا نعيد استخدام الـpacking المحفوظ، وقت قراءة الـmetadata صار أوضح. ولما فصلت قياسها عن قراءة جدول الـtensors، طلع تقريباً كل وقت القراءة رايح عليها.
مصفوفات الـtokenizer داخل GGUF فيها مئات الآلاف من الإدخالات، وكان الـloader ينشئ لها قيماً ونصوصاً منفصلة في الذاكرة. بس Ember أصلاً يقرأ الـtokenizer من tokenizer.json. المصفوفات الأربع هذي ما كان فيه شي يستخدمها.
الـloader الآن يتحقق من نوع العناصر وعددها، وحدود أطوال النصوص والحدود الإجمالية، وصحة UTF-8، وهو يمر عليها مباشرة في الملف. بعدها يسجل SkippedArray { element_type, elements }. مفاتيح الـmetadata تبقى موجودة، والـinspect يعرض نوع المصفوفة اللي تجاوزها وعدد عناصرها.
وكان فيه شغل زيادة في مكان ثاني: بناء مفتاح الـcache كان يحوّل كل قيمة metadata إلى نص بصيغة Debug. لما حطيت حدود لهذا الشغل، وقت تشغيل الأمر كامل في الحالة الدافئة نزل من 342 إلى 274 مللي ثانية في Llama، ومن 2,340 إلى 1,927 في Gemma، في مقارنة مستقلة.
مقارنة مفتاح الـcache ومقارنة تجاوز المصفوفات كل وحدة لها نسختها قبل التعديل وبعده. عشان كذا ما نخلط أرقامها كأنها قياس واحد.
في مسار الـdecode، ما عاد فيه داعي نرجع نبحث في cache خطط التنفيذ عند كل توكن إذا إعداد الجلسة ما تغير. وكمان صار الكود اللي يستدعي النموذج يعيد استخدام نفس buffer الـlogits.
مسار Q4 المخطط نزل من خمسة تخصيصات و515,716 بايت لكل توكن إلى تخصيصين و3,040 بايت. التخصيصات اللي بقيت كانت لهياكل مهام Rayon وقت التنافس داخل الـthread pool.
وكمان تغير وضع الـdecode الافتراضي في CLI لـLlama/Qwen3 من reference إلى planned، فصار المسار الأقل تخصيصاً هو اللي تستخدمه عادة. في اختبار Llama Q4 هذا، الافتراضي القديم كان يسوي 833 تخصيصاً لكل توكن؛ الجديد يسوي اثنين.
بس المقارنة الكبيرة هذي تجمع تغيير الافتراضي مع إعادة استخدام الـbuffer. مو كلها مكسب من الـbuffer لحاله.
السرعة بقيت داخل ضوضاء القياس. في المقارنة المتداخلة النهائية، Q4 المخطط سجل 27.19 مقابل 26.90 توكن في الثانية، وQ8 سجل 22.17 مقابل 22.62. عدد التخصيصات نزل كثير، بس هذي الأرقام ما تثبت إن الـdecode صار أسرع.
وقبل ما أغير الافتراضي، المسار الجديد عدّى الفحوص العددية. توكنات Q4 مع greedy decoding تطابقت عبر 24 خطوة وستة prompts ثابتة مسبقاً، والـlogits بقيت داخل هامش 1e-3 المحدد.
وكمان مخرجات 18 تشغيلة بـgreedy decoding عبر Q4 وQ6 وQ8 تطابقت بايت ببايت. عقد التنفيذ يسجل القرار، والمسار المرجعي لسه متاح. أما planned-fused فبقي خيار تشغله بنفسك، لأن فرق سرعته عن planned كان برضه داخل ضوضاء القياس.
الـprofile لسه يبين إن حوالي 87% من دورات المعالج المأخوذة بالعينة تروح لنواتي الضرب النقطي لـK-quant. شغل بداية التشغيل ما يشيل هذي الكلفة. عشان نجرب تحسينات جديدة على النوى، نحتاج ظروف تشغيل مستقرة ومقارنة جديدة مع المسار الموجود.
المكسب العملي هذا الأسبوع: التشغيلات الجديدة تستفيد من ترتيب الأوزان المحفوظ، والـloader ما يحتفظ بـmetadata ما يستخدمها، والـdecode العادي يخصص ذاكرة أقل. كل نتيجة هنا لها قياسها وفحص صحتها. لما نعرف بالضبط إيش تحسن وإيش بقي زي ما هو، يصير أسهل نحدد فين نشتغل بعدها.
planned وplanned-fused والافتراضي الحالي.الرسم يستخدم الأرقام الموثقة مباشرة، وألوانه تتغير مع مظهر الموقع. تقدر تعيد بناء صفحتي العربي والإنجليزي محلياً بدون تشغيل inference:
python docs/assets/build_startup_post.py